NatusAI
Relationer
Kunder, udstyr, kontrakter og hændelser forbundet direkte, så ejerskab, afhængigheder og årsager er lette at følge.
 Forbundet datafundament · Lag 01 · Forbundet fundamentPlanlagt v1
Cygnus er NatusAI-platformens planlagte datafundament – en vidensdatabase til digitale tvillinger. Den holder aktiver, dokumenter, placeringer, målinger og deres relationer samlet, så mennesker og godkendte AI-assistenter kan besvare spørgsmål, der før tog dage.
Planlagt omfang af v1 og 25 acceptkriterier →Roadmap: senere profiler →
En sensormåling har et tidspunkt, et sted, et aktiv og en kilde. En kontrakt henviser til det samme aktiv. Cygnus bevarer disse forbindelser, så svarene følger dem i stedet for at genopbygge dem hver gang.
Kunder, udstyr, kontrakter og hændelser forbundet direkte, så ejerskab, afhængigheder og årsager er lette at følge.
Hvem driver hvad, hvilken rapport beskriver hvilken hændelse: fakta knyttet til de ting, de beskriver.
Positioner, spor og områder knyttet til de aktiver, de hører til, og til deres historik.
Målinger gemt ved siden af de aktiver, de beskriver – fra ét øjeblik til mange års historik.
Find information ud fra, hvad den siger, og følg den tilbage til den oprindelige kilde.
Navne, id’er og tekstpassager kombineret med relationer, sted og tid.


Et skib sejlede ind i et stormområde kl. 14.00. En korrigeret position kom kl. 14.10. Cygnus er designet til at genskabe beslutningen kl. 14.05 med det, man vidste på det tidspunkt, eller til at vise det korrigerede billede. Det er den historik, en revisor eller en tilsynsmyndighed beder om.
Cygnus er planlagt til at kombinere sit eget typede programmeringssprog med lagring, udførelse og tjenester. Forretningslogikken arbejder direkte med persistente entiteter og deres relationer, så der skal oversættes mindre mellem databaserækker, applikationsobjekter og API-svar.
Den samme typede model fører data fra varig lagring ind i applikationslogik og tjenestekontrakter. Færre mappinger betyder færre steder, hvor typer, feltnavne og relationsdefinitioner kan glide fra hinanden.
Start fra et indekseret indgangspunkt, følg de relationer, du har brug for, og afgræns efter tid, sted eller søgning. Den optimerede forespørgselsmodel sigter mod at udføre arbejdet tæt på lagringen og kun returnere det ønskede resultat.
Typede funktioner bliver til applikationstjenester og godkendte værktøjer. HTTP/RPC, streaming, genererede TypeScript-klienter og MCP-beskrivelser er en del af backend-designet, så der er færre separate adapterlag at vedligeholde.
En stor graf behøver ikke at blive indlæst fuldt ud i hukommelsen. Persistente referencer lader en operation hente relevante noder, indekssider og tidsintervaller, efterhånden som der er brug for dem.
At se på ét skib bør ikke kræve, at alle skibe, alle dokumenter og hele positionshistorikken indlæses. Selektiv traversering og afgrænsede læsninger er designet til at holde hukommelsesforbruget knyttet til det arbejde, der faktisk udføres.
Det er vejen til hurtigere forbundne forespørgsler og lavere ressourceforbrug: mindre materialisering, færre overførsler mellem tjenester og mindre duplikeret kontekst. Den faktiske gevinst afhænger af graf, indeks, arbejdsbelastning og hardware.
Illustrativ adgangssti
01 / Varig graf
Skib · Last · Rute · andre skibe · anden last · ældre intervaller bliver på disken.
Først berøres kun referencer og et indekseret udvalg.
02 / Relevant arbejdssæt
Valgt skib → last → ønsket spor
Hent de forbundne data og det tidsvindue, denne operation bruger.
03 / Afgrænset resultat
Side · stikprøve · strøm
Returnér en side, en stikprøve eller en strøm. Store eksporter og genopbygninger bruger afgrænset behandling eller varige jobs.
Relationelle systemer fungerer godt til strukturerede poster og SQL-rapportering. Når en forbundet applikation får historik, kort, semantisk søgning og AI, flytter omkostningen sig ofte mod joins, objektmapping og koordinering af ekstra tjenester. Cygnus er designet til at reducere det overhead i én programmerbar motor.
| Dimension | Tabelbaseret lagring + applikationsstak | Cygnus’ samlede temporale graf (planlagt) |
|---|---|---|
| Datalagring | Entiteter bliver til rækker; relationer bruger nøgler og ofte koblingstabeller. Applikationskoden mapper rækker til objekter. | Typede entiteter og persistente links deler én model på tværs af lagring, logik og tjenester. |
| Forbundne forespørgsler | Joins genskaber relationerne, når der forespørges. Dybe stier kan øge kompleksiteten i forespørgsler og mapping. | Indekserede indgangspunkter og graftraversering følger lagrede relationer med tidsmæssige og geografiske afgrænsninger. |
| Hukommelse og dataflytning | Effektive motorer bruger allerede indeks og caches; brede joins og behandling på applikationssiden kan stadig skabe store mellemresultater. | Hent grafdata efter behov; brug afgrænsede intervaller, sider og strømme i stedet for at materialisere hele det forbundne datasæt. |
| Historik og rettelser | Historiktabeller, temporale udvidelser eller hændelsesmodeller skal designes og afstemmes med applikationens forespørgsler. | Temporal tilstand og bitemporal adgang er en del af modellen og bevarer forskellen mellem gyldighedstid og videnstid. |
| Geodata, tekst og vektorer | Udvidelser kan tilføje kapabiliteter i én database; specialiserede tjenester kan have brug for egne stier til identitet, indeksering og synkronisering. | Geografiske ressourcer, tidsserier, tekst og vektorer er koblet til de samme entiteter og versionerede kilder. |
| Forespørgsels- og applikationssprog | SQL plus applikationskode, mappingbiblioteker og nogle gange separate søge- eller grafforespørgselssprog. | Ét indbygget typet sprog og en optimeret forespørgselsmodel bringer beregningen tæt på de persistente grafstrukturer. |
| Vedligeholdelse og videreudvikling | Koordinér databaseskemaer, mappinger, tjenestekontrakter og eventuelle separat drevne søgelagre. | Fælles typebeskrivelser og tjenestekontrakter reducerer dobbelte definitioner; migreringer og indeksændringer følger eksplicit versionsadfærd. |
| AI og adgangskontrol | Typisk tilføjes en værktøjsgateway og et chatlag, hvorefter deres rettigheder skal afstemmes med de datastier, de kalder. | Indbygget MCP og en afgrænset chatkontrakt bruger de samme typede tjenester, med autorisation i lagrings- og udførelsesstierne. |
Sådan måler du det: den tilsigtede fordel er hurtigere arbejde med mange relationer og mindre overhead til mapping, synkronisering og ressourcer. Mål forespørgselssvartid, maksimalt hukommelsesforbrug, disk-I/O, indlæsning og vedligeholdelsesindsats på samme arbejdsbelastning og hardware. Et datavarehus eller en moden SQL-stak kan fortsat passe bedre til store tabelbaserede analyser eller nødvendige udvidelser.
Et AI-svar bliver mere nyttigt, når det kan koble det rigtige dokument til den rigtige entitet, det rigtige sted og det rigtige øjeblik. Cygnus er planlagt til at samle søgning, kaldbar forretningslogik og samtaleregistreringer i backend-modellen.
Model Context Protocol giver godkendte agenter en typet måde at finde og bruge backend-funktioner på. Opdagelse og udførelse af værktøjer følger kalderens rettigheder og bruger de samme tjenestekontrakter som applikationerne.
Den planlagte leverandørneutrale chatkontrakt dækker beskeder, streaminghændelser, værktøjskald, struktureret output og varige registreringer af sessioner og kørsler. Lokale eller eksterne modelbindinger vælges og kvalificeres eksplicit for installationen.
Kombinér fuldtekst- og vektorsøgning med kontekst fra graf, geografi og historik. Bevar henvisninger til kildeversioner og den valgte tidskontekst, så et menneske kan efterprøve dokumentationen og forstå, hvordan et svar blev til.
Regler for dataadgang anvendes før visning og søgerangering. Hentet indhold og modeloutput giver ikke tilladelse til at handle; beskyttede handlinger kræver deres egen godkendelse og, hvor det er angivet, en menneskelig beslutning.
»Hvilken last var om bord på skibe inden for stormområdet i går, og hvilke rapporter forklarer risikoen?«
Denne foreslåede maritime arbejdsbelastning samler arkitekturen. Samme tilgang kan forbinde udstyr, telemetri og vedligeholdelse i applikationer til energi, produktion eller infrastruktur.
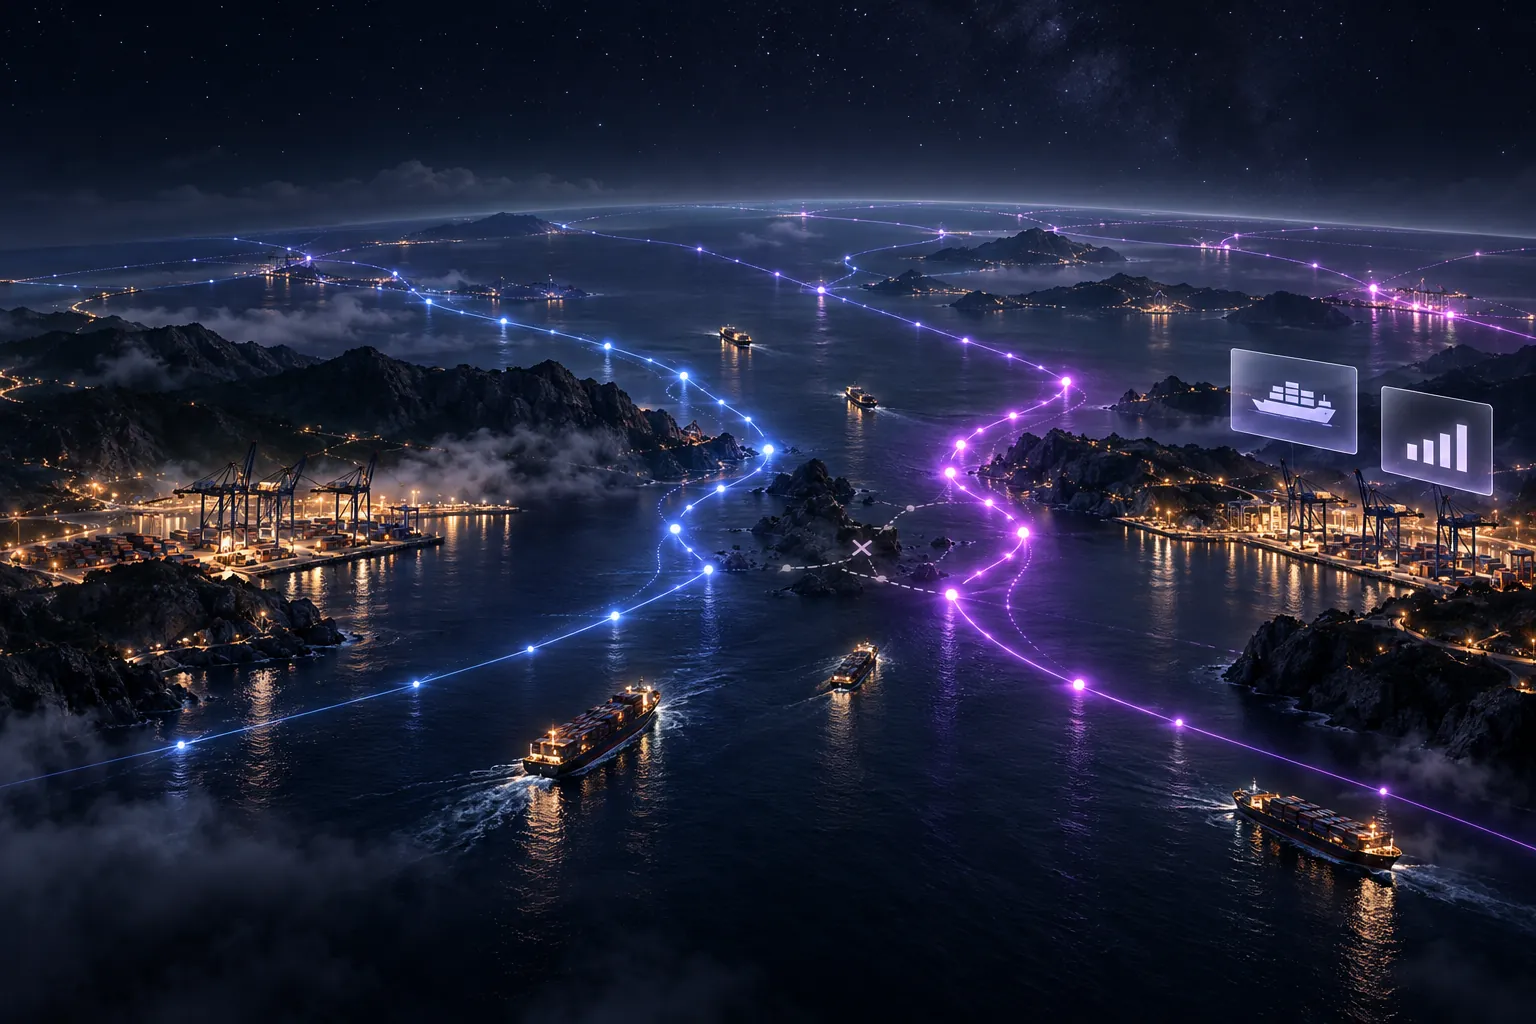
Sådan bygges svaret
Vælg gårsdagens interval, og om spørgsmålet bruger det, man vidste dengang, eller senere korrigeret dokumentation.
Brug geografisk udvælgelse og tidsserieintervaller til at finde de skibe, hvis spor krydsede stormområdet.
Traversér skibets historiske relationer til last, operatører og havne, og hent de nødvendige dele af grafen.
Kombinér nøgleords- og semantisk søgning i godkendte dokumentversioner, koblet til de valgte entiteter og den valgte tidskontekst.
En typet tjeneste eller et MCP-værktøj returnerer dokumentationen. Chatten kan forklare den og samtidig bevare kilderne og den relevante kontekst.
Vi skelner mellem det, der er bevist, og det, der er på vej, og mærker begge dele. NatusAI Cygnus er planlagt til sin første version (v1).
Cygnus rummer data og forretningslogik. NatusAI Lyra viser dem, NatusAI Auriga og Aquila lader AI arbejde med dem, NatusAI Orion bygger applikationer på dem, NatusAI Draco driver dem, og NatusAI Gemini gendanner dem.
Hvad Cygnus er. En planlagt programmerbar temporal grafdatabase: sit eget typede sprog, en optimeret forespørgselsmodel og en backend-runtime. Graf, geospatial, vektor, triple-store-semantik, tidsserier og fuldtekstsøgning deler én model med én identitet, én transaktionsmodel og én autorisationsgrænse.
| Profil | Første version | Afgrænsning |
|---|---|---|
| Indlejret | Inkluderet | Én applikationsproces med lokal lagring. |
| Udvikling | Inkluderet | Opstart af tomt projekt og eksplicitte kildetilstande. |
| Produktion, én server | Inkluderet | Én node; backup, gendannelse til et bestemt tidspunkt og verificeret gendannelse er omfattet. |
| Klynge | Udeladt | Ingen påstand om sharding, replikering, distribueret traversering eller failover. |
| Isoleret arbejdsbelastning | Udeladt | Ingen separat kvalificeret profil til isolerede arbejdsbelastninger. |
| Kriterium | Foreslået tærskel | Status |
|---|---|---|
| Designpartnere i produktion på referencearbejdsbelastningen | Mindst 3 | Endnu ikke bestået |
| Produktionssystem med opbevaret historik som autoritativ kilde | Mindst 1, med 6+ måneders historik | Endnu ikke bestået |
| Vedvarende indlæsning af positioner, referenceklasse med 32 vCPU | ≥ 100.000 rapporter/s | Endnu ikke bestået |
| Skibe inden for en polygon blandt 250.000 live-positioner | p99 ≤ 150 ms | Endnu ikke bestået |
| Hybrid top-20-søgning i 5 millioner dokumenter | p99 ≤ 300 ms | Endnu ikke bestået |
| Korrekthed ved out-of-core-drift | Datasæt ≥ 24 × RAM | Endnu ikke bestået |
| Overhead ved autorisation på elementniveau | ≤ 2 × grovkornet politik | Endnu ikke bestået |
| Kvitterede commits tabt på én server | Nul | Endnu ikke bestået |
| Planlagte test af verificeret gendannelse | 100 % bestået | Endnu ikke bestået |
| Agentdrevne evalueringer af tomme projekter uden menneskelig reparation | ≥ 70 % lykkes | Endnu ikke bestået |
Kører på dine servere som ét system, uden separate søge-, graf- og tidsserietjenester, der skal licenseres og sikres.
Svarene bevarer henvisninger til den kildeversion og det tidspunkt, de har brugt.
Regler for dataadgang anvendes, før noget vises eller rangeres. Hentet tekst giver aldrig en AI tilladelse til at handle.
Verificeret gendannelse og gendannelse til et bestemt tidspunkt er krav til versionen, ikke tilvalg.
Udfordringer, tilgange og nyttige resultater fra vores branchecases og referencearkitekturer. Hvert eksempel fremhæver de dimensioner, der gør problemet egnet til Cygnus’ planlagte samlede model.
01 · Bank og finans
Konti → Transaktioner → Efterforskning
Cygnus-matchGrafTriplerTidshistorikFuldtekst
02 · Energi og forsyning
Netaktiver → Måleraflæsninger → Vedligeholdelse
Cygnus-matchGrafGeodataTidsserierTidshistorik
03 · Produktion
Udstyr → Sensorhistorik → Indgreb
Cygnus-matchGrafTidsserierTidshistorik
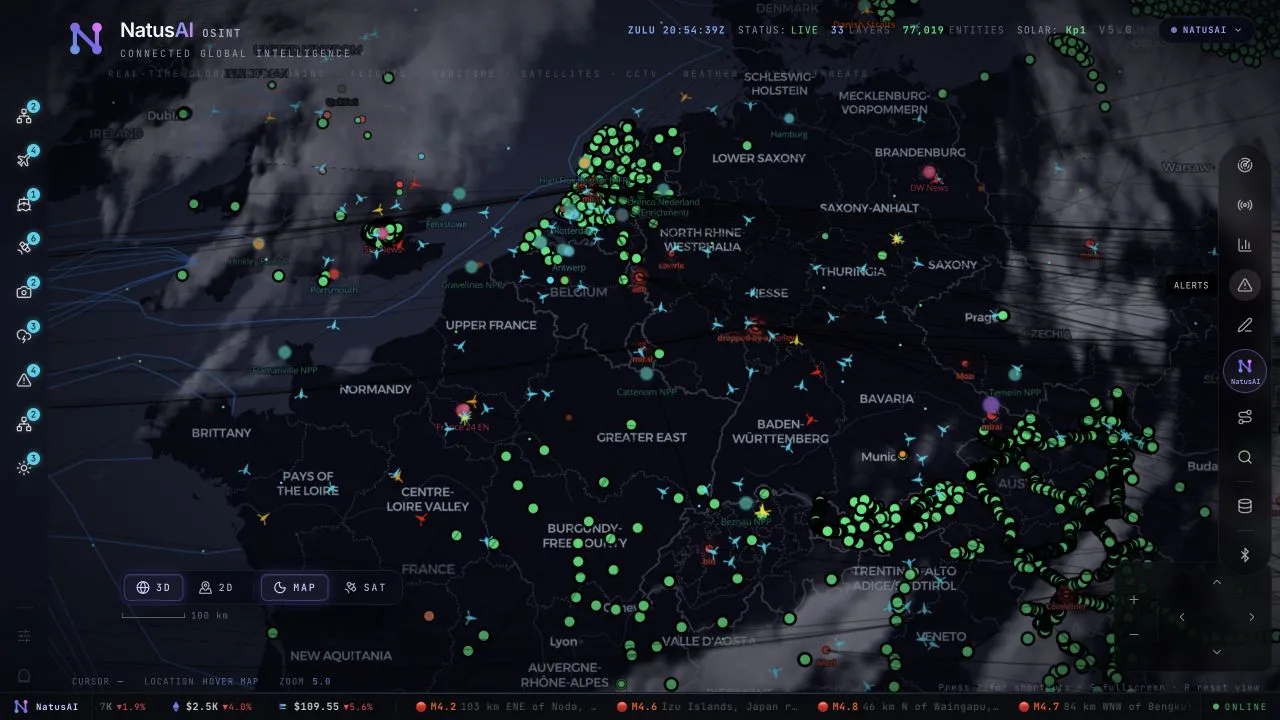
04 · OSINT
Steder og hændelser → Kilderapporter → Vurdering
Cygnus-matchGeodataGrafFuldtekstTidshistorik
05 · Planlægning af solenergi og infrastruktur
Bygninger → Solforhold → Scenarier
Cygnus-matchGeodataGrafTidsserier
06 · Telekommunikation
Kunde → Serviceanmodning → Overdragelse til en medarbejder
Cygnus-matchGrafFuldtekstTidshistorikChat
07 · Handel og forsyningskæder
Handelsstrømme → Afhængigheder → Forstyrrelse
Cygnus-matchGrafGeodataTidshistorikChat
Disse cases beskriver projekter, udforskede arbejdsgange og referencearkitekturer. Cygnus-match-mærkerne kobler dem til det planlagte produkt; de dokumenterer ikke en frigivet Cygnus-installation.

Et fundament i par
NatusAI Lyra leverer genbrugelige webkomponenter til kort, grafer, søgning og applikationsarbejdsgange. Den bredere integration med Orion og Cygnus er en del af platformvisionen. Se NatusAI Lyra
Genanvendelige brugerfladekomponenter til dashboards, kort, dokumenter og AI-samtaler.
Gør dokumenter til viden, du kan henvise til – med kilden ét klik væk.
AI-assistenter og værktøjer, der arbejder inden for de rettigheder og budgetter, dine medarbejdere fastsætter.
Korte svar til beslutningstagere. Dit tekniske team finder detaljerne i afsnittet ovenfor.
Ikke endnu. Cygnus er planlagt til en første version, der først godkendes, når de fastlagte accepttest er bestået. Samme motor som i vores kundeprojekter er allerede afprøvet i praksis, og vores team bygger på den i dag.
Nej. Den første version er rettet mod én server. En verdensomspændende datamodel kan køre på én node inden for de testede grænser; global geografi betyder ikke, at der kræves en klynge.
Ikke nødvendigvis. Cygnus er designet til forbundet arbejde med mange relationer. Til store tabelbaserede rapporter kan et datavarehus eller en moden SQL-stak fortsat passe bedre, og Cygnus kan stå ved siden af.
Tag ét med. Vi viser dig, hvordan en forbundet model ville besvare det, og hvad det ville kræve.
Eller skriv til contact@natusai.com