NatusAI
Relaciones
Clientes, equipos, contratos y eventos vinculados directamente, para seguir con facilidad la titularidad, las dependencias y las causas.
 Base de datos conectada · Capa 01 · Base conectadaV1 prevista
Cygnus es la base de datos prevista de la plataforma NatusAI. Mantiene juntos activos, documentos, ubicaciones, mediciones y sus relaciones, para que las personas y los asistentes de IA aprobados respondan a preguntas que antes llevaban días.
Alcance previsto de la v1 y 25 criterios de aceptación →Hoja de ruta: perfiles posteriores →
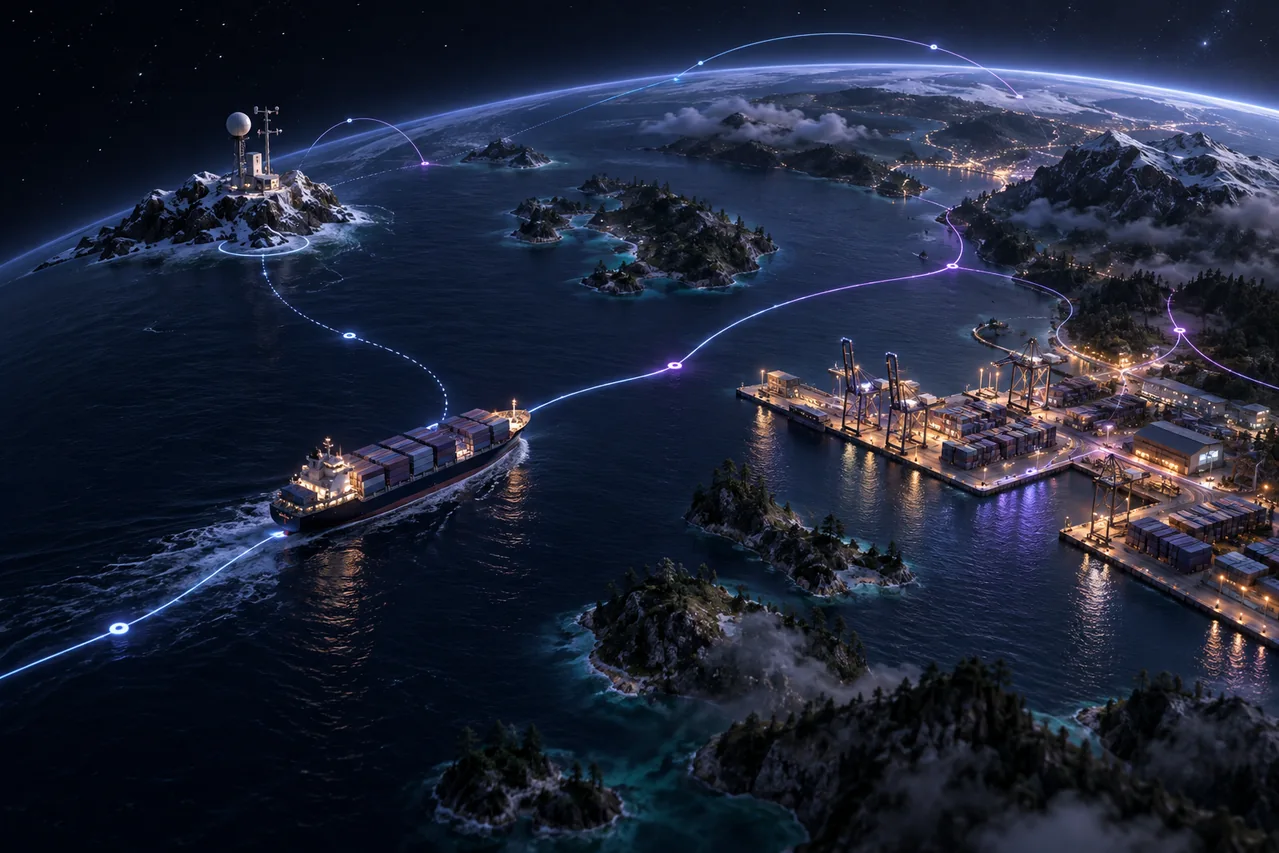
Una lectura de un sensor tiene una hora, un lugar, un activo y una fuente. Un contrato se refiere al mismo activo. Cygnus conserva estas conexiones, de modo que las respuestas las siguen en lugar de reconstruirlas cada vez.
Clientes, equipos, contratos y eventos vinculados directamente, para seguir con facilidad la titularidad, las dependencias y las causas.
Quién opera qué, qué informe describe qué incidente: hechos ligados a aquello que describen.
Posiciones, trayectorias y zonas vinculadas a los activos a los que pertenecen y a su historial.
Lecturas guardadas junto a los activos que describen, desde un instante hasta años de historial.
Encuentre información por lo que dice y remóntela hasta la fuente original.
Nombres, identificadores y pasajes, combinados con relaciones, lugar y tiempo.


Un buque entró en una zona de tormenta a las 14:00. A las 14:10 llegó una posición corregida. Cygnus está diseñada para reconstruir la decisión de las 14:05 con lo que se sabía en ese momento, o para mostrar la imagen corregida. Ese es el historial que pide un auditor o un supervisor.
Está previsto que Cygnus combine su propio lenguaje de programación tipado con el almacenamiento, la ejecución y los servicios. La lógica de negocio trabaja directamente con entidades persistentes y sus relaciones, lo que reduce la traducción entre filas de base de datos, objetos de aplicación y respuestas de API.
El mismo modelo tipado lleva los datos desde el almacenamiento persistente hasta la lógica de aplicación y los contratos de servicio. Menos correspondencias significan menos puntos en los que tipos, nombres de campo y definiciones de relaciones pueden desalinearse.
Parta de un punto de entrada indexado, siga las relaciones que necesite y acote por tiempo, espacio o búsqueda. El modelo de consulta optimizado pretende realizar ese trabajo cerca del almacenamiento y devolver solo el resultado solicitado.
Las funciones tipadas se convierten en servicios de aplicación y herramientas autorizadas. HTTP/RPC, streaming, clientes TypeScript generados y descriptores MCP forman parte del diseño del backend, lo que reduce las capas de adaptación independientes que hay que mantener.
No es necesario cargar en memoria un grafo grande en su totalidad. Las referencias persistentes permiten que una operación resuelva los nodos, las páginas de índice y los rangos temporales relevantes a medida que los necesita.
Consultar un buque no debería obligar a cargar todos los buques, todos los documentos y todo el historial de posiciones. El recorrido selectivo y las lecturas acotadas están diseñados para que el uso de memoria dependa del trabajo que se realiza.
Ese es el camino hacia consultas conectadas más rápidas y un menor consumo de recursos: menos materialización, menos transferencias entre servicios y menos contexto duplicado. Las mejoras reales dependen del grafo, los índices, la carga de trabajo y el hardware.
Ruta de acceso ilustrativa
01 / Grafo persistente
Buque · Carga · Ruta · otros buques · otras cargas · los rangos más antiguos se quedan en disco.
Al principio solo se tocan las referencias y una selección indexada.
02 / Conjunto de trabajo relevante
Buque seleccionado → carga → trayectoria solicitada
Resolver los datos conectados y la ventana temporal que utiliza esta operación.
03 / Resultado acotado
Página · muestra · flujo
Devolver una página, una muestra o un flujo. Las exportaciones y reconstrucciones grandes utilizan procesamiento acotado o trabajos persistentes.
Los sistemas relacionales funcionan bien para registros estructurados e informes SQL. Cuando una aplicación conectada incorpora historial, mapas, recuperación semántica e IA, el coste suele desplazarse hacia los joins, el mapeo de objetos y la coordinación de servicios adicionales. Cygnus está diseñada para reducir ese sobrecoste dentro de un único motor programable.
| Dimensión | Almacenamiento tabular + pila de aplicación | Grafo temporal unificado de Cygnus (previsto) |
|---|---|---|
| Almacenamiento de datos | Las entidades se convierten en filas; las relaciones usan claves y, a menudo, tablas de enlace. El código de la aplicación convierte las filas en objetos. | Las entidades tipadas y los enlaces persistentes comparten un único modelo entre almacenamiento, lógica y servicios. |
| Consultas conectadas | Los joins reconstruyen las relaciones en el momento de la consulta. Las rutas profundas pueden añadir complejidad de consulta y de mapeo. | Los puntos de entrada indexados y el recorrido del grafo siguen las relaciones almacenadas, con restricciones temporales y espaciales. |
| Memoria y movimiento de datos | Los motores eficientes ya usan índices y cachés; aun así, los joins amplios y el procesamiento en la aplicación pueden generar grandes resultados intermedios. | Resolver los datos del grafo bajo demanda; usar rangos acotados, páginas y flujos en lugar de materializar todo el conjunto de datos conectado. |
| Historial y correcciones | Las tablas de historial, las extensiones temporales o los modelos de eventos deben diseñarse y alinearse con las consultas de la aplicación. | El estado temporal y el acceso bitemporal forman parte del modelo, y preservan la distinción entre tiempo de validez y tiempo de conocimiento. |
| Geodatos, texto y vectores | Las extensiones pueden añadir capacidades en una sola base de datos; los servicios especializados pueden necesitar sus propias rutas de identidad, indexación y sincronización. | Los recursos espaciales, de series temporales, de texto y vectoriales se conectan a las mismas entidades y fuentes versionadas. |
| Lenguajes de consulta y de aplicación | SQL más código de aplicación, bibliotecas de mapeo y, a veces, lenguajes de búsqueda o de consulta de grafos independientes. | Un lenguaje tipado nativo y un modelo de consulta optimizado acercan el cálculo a las estructuras persistentes del grafo. |
| Mantenimiento y evolución | Coordinar esquemas de base de datos, mapeos, contratos de servicio y cualquier almacén de recuperación operado por separado. | Los descriptores de tipos y contratos de servicio compartidos reducen las definiciones duplicadas; las migraciones y los cambios de índices siguen un comportamiento de versiones explícito. |
| IA y control de acceso | Normalmente se añade una pasarela de herramientas y una capa de chat, y luego hay que alinear sus permisos con las rutas de datos que invocan. | MCP nativo y un contrato de chat acotado usan los mismos servicios tipados, con la autorización en las rutas de almacenamiento y ejecución. |
Cómo medirlo: la ventaja que se busca es un trabajo intensivo en relaciones más rápido, con menos sobrecoste de mapeo, sincronización y recursos. Mida la latencia de las consultas, la memoria máxima, la E/S de disco, la ingesta y el esfuerzo de mantenimiento con la misma carga de trabajo y el mismo hardware. Un data warehouse o una pila SQL madura puede seguir siendo la mejor opción para la analítica tabular a gran escala o cuando se requieren determinadas extensiones.
Una respuesta de IA resulta más útil cuando puede vincular el documento adecuado con la entidad, la ubicación y el momento adecuados. Está previsto que Cygnus integre en el modelo de backend la recuperación, la lógica de negocio invocable y los registros de conversación.
El Model Context Protocol ofrece a los agentes autorizados una forma tipada y descubrible de usar las funciones del backend. El descubrimiento y la ejecución de herramientas respetan los permisos de quien llama, con los mismos contratos de servicio que usan las aplicaciones.
El contrato de chat previsto, neutral respecto al proveedor, abarca mensajes, eventos de streaming, llamadas a herramientas, salida estructurada y registros persistentes de sesiones y ejecuciones. Las vinculaciones con modelos locales o remotos se seleccionan y cualifican de forma explícita para cada despliegue.
Combine la recuperación de texto completo y vectorial con el contexto de grafo, espacial e histórico. Conserve las referencias a las versiones de las fuentes y al contexto temporal elegido, para que una persona pueda examinar la evidencia y entender cómo se formó una respuesta.
Las reglas de acceso a datos se aplican antes de mostrar resultados y de ordenar la búsqueda. Ni el contenido recuperado ni la salida del modelo conceden permiso para actuar; las acciones protegidas requieren su propia autorización y, cuando así se especifica, una decisión humana.
«¿Qué carga llevaban ayer los buques que estaban dentro de la zona de tormenta, y qué informes explican el riesgo?»
Esta carga de trabajo marítima propuesta reúne toda la arquitectura. El mismo enfoque puede conectar equipos, telemetría y mantenimiento en aplicaciones de energía, fabricación o infraestructuras.
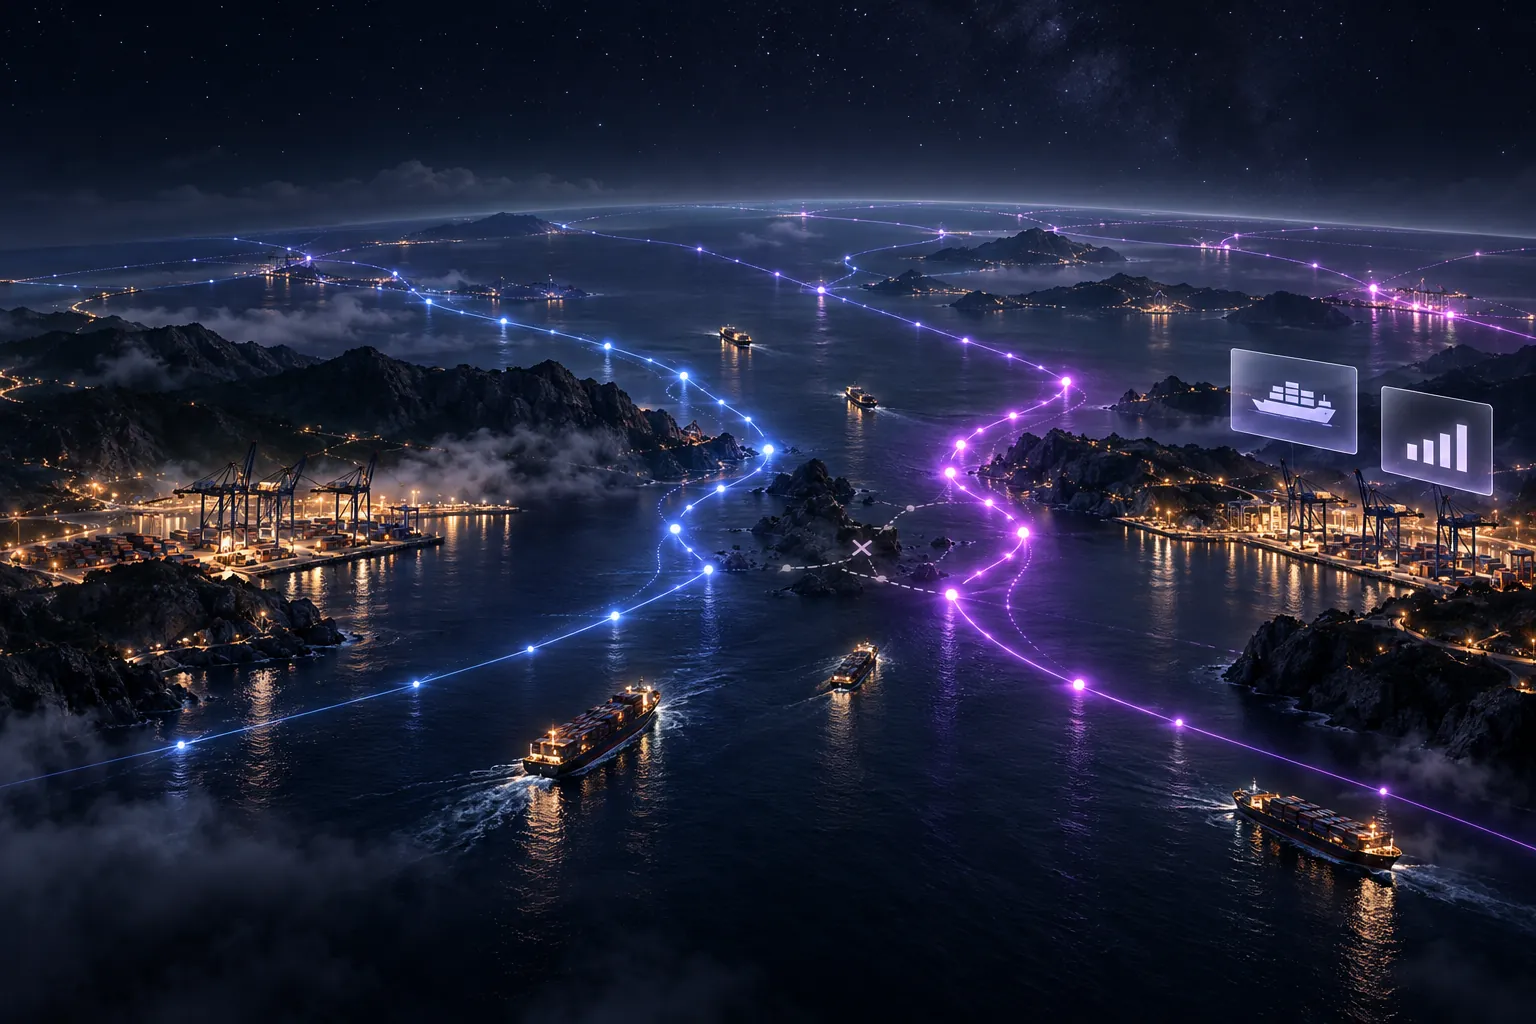
Cómo se construye la respuesta
Seleccione el intervalo de ayer y decida si la pregunta usa lo que se sabía entonces o la evidencia corregida después.
Use la selección geoespacial y los rangos de series temporales para identificar los buques cuyas trayectorias cruzaron la zona de tormenta.
Recorra las relaciones históricas del buque con cargas, operadores y puertos, resolviendo solo las partes necesarias del grafo.
Combine la búsqueda por palabra clave y la búsqueda semántica sobre versiones de documentos autorizadas, vinculadas a las entidades y al contexto temporal seleccionados.
Un servicio tipado o una herramienta MCP devuelve la evidencia. El chat puede explicarla conservando las fuentes y el contexto relevante.
Separamos lo probado de lo que está por llegar, y etiquetamos ambos. NatusAI Cygnus tiene prevista su primera versión (v1).
Cygnus alberga los datos y la lógica de negocio. NatusAI Lyra los muestra, NatusAI Auriga y Aquila permiten que la IA trabaje con ellos, NatusAI Orion construye aplicaciones sobre ellos, NatusAI Draco los ejecuta y NatusAI Gemini los recupera.
Qué es Cygnus. Una base de datos de grafos temporal y programable (prevista), con su propio lenguaje tipado, un modelo de consulta optimizado y un entorno de ejecución de backend. Grafos, datos geoespaciales, vectores, semántica de triple store, series temporales y búsqueda de texto completo comparten un único modelo, con una identidad, un modelo transaccional y un límite de autorización.
| Perfil | Primera versión | Límite |
|---|---|---|
| Embebido | Incluido | Un proceso de aplicación con almacenamiento local. |
| Desarrollo | Incluido | Arranque de proyecto vacío y modos de fuente explícitos. |
| Producción, un solo servidor | Incluido | Un nodo; copia de seguridad, recuperación a un punto en el tiempo y restauración verificada incluidas en el alcance. |
| Clúster | Excluido | No se afirma particionado (sharding), replicación, recorrido distribuido ni conmutación por error. |
| Carga de trabajo aislada | Excluido | Sin perfil de carga de trabajo aislada cualificado por separado. |
| Criterio | Umbral propuesto | Estado |
|---|---|---|
| Socios de diseño en producción con la carga de trabajo de referencia | Al menos 3 | Aún no superado |
| Sistema de registro en producción con historial conservado | Al menos 1, con más de 6 meses de historial | Aún no superado |
| Ingesta sostenida de posiciones, clase de referencia de 32 vCPU | ≥ 100 000 informes/s | Aún no superado |
| Buques dentro de un polígono sobre 250 000 posiciones en vivo | p99 ≤ 150 ms | Aún no superado |
| Recuperación híbrida top-20 sobre 5 millones de documentos | p99 ≤ 300 ms | Aún no superado |
| Corrección fuera de memoria | Conjunto de datos ≥ 24 × RAM | Aún no superado |
| Sobrecoste de la autorización por elemento | ≤ 2 × política de grano grueso | Aún no superado |
| Commits confirmados perdidos en un servidor | Cero | Aún no superado |
| Pruebas programadas de restauración verificada | 100 % superadas | Aún no superado |
| Evaluaciones de proyecto vacío dirigidas por agentes sin reparación humana | ≥ 70 % con éxito | Aún no superado |
Se ejecuta en sus servidores como un único sistema, sin servicios separados de búsqueda, grafos y series temporales que licenciar y proteger.
Las respuestas conservan referencias a la versión de la fuente y al momento temporal que utilizaron.
Las reglas de acceso a datos se aplican antes de mostrar u ordenar nada. Un texto recuperado nunca concede a una IA permiso para actuar.
La restauración verificada y la recuperación a un punto en el tiempo son requisitos de la versión, no opciones.
Los problemas, enfoques y resultados útiles de nuestras historias sectoriales y arquitecturas de referencia. Cada ejemplo destaca las dimensiones que hacen que el problema encaje con el modelo unificado previsto de Cygnus.
01 · Banca y servicios financieros
Cuentas → Transacciones → Investigación
Encaje con CygnusGrafoTripletasHistorial temporalTexto completo
02 · Energía y servicios públicos
Activos de red → Lecturas de contadores → Mantenimiento
Encaje con CygnusGrafoGeoespacialSeries temporalesHistorial temporal
03 · Fabricación
Equipo → Historial de sensores → Intervención
Encaje con CygnusGrafoSeries temporalesHistorial temporal
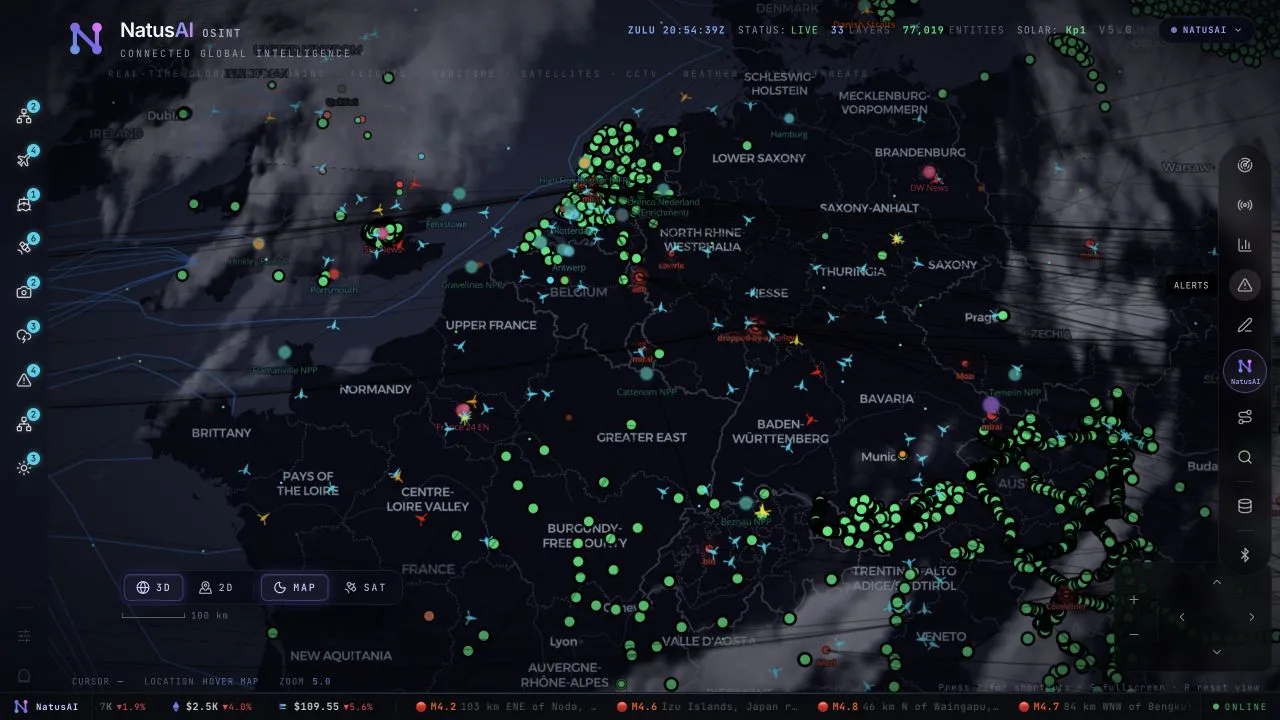
04 · OSINT
Lugares y eventos → Informes de fuentes → Evaluación
Encaje con CygnusGeoespacialGrafoTexto completoHistorial temporal
05 · Planificación solar y de infraestructuras
Edificios → Condiciones solares → Escenarios
Encaje con CygnusGeoespacialGrafoSeries temporales
06 · Telecomunicaciones
Cliente → Solicitud de servicio → Traspaso a una persona
Encaje con CygnusGrafoTexto completoHistorial temporalChat
07 · Comercio y cadenas de suministro
Flujos comerciales → Dependencias → Interrupción
Encaje con CygnusGrafoGeoespacialHistorial temporalChat
Estas historias describen proyectos, flujos de trabajo explorados y arquitecturas de referencia. Las etiquetas de encaje con Cygnus los relacionan con el producto previsto; no acreditan un despliegue de Cygnus ya publicado.

Una base complementaria
NatusAI Lyra ofrece componentes web reutilizables para mapas, grafos, búsqueda y flujos de trabajo de aplicaciones. La integración más amplia con Orion y Cygnus forma parte de la visión de la plataforma. Descubrir NatusAI Lyra
Componentes de interfaz reutilizables para cuadros de mando, mapas, documentos y conversaciones con IA.
Convierta documentos en conocimiento que se puede citar, con la fuente a un clic.
Asistentes de IA y herramientas que trabajan dentro de los permisos y presupuestos que fijan sus equipos.
Respuestas breves para quienes deciden. Su equipo técnico encontrará el detalle en la sección desplegable de arriba.
Todavía no. Cygnus tiene prevista una primera versión que solo se aceptará cuando supere las pruebas de aceptación definidas. El mismo motor de nuestros proyectos con clientes ya está probado en proyectos reales, y nuestro equipo construye hoy sobre él.
No. La primera versión está pensada para un único servidor. Un modelo de datos mundial puede ejecutarse en un solo nodo dentro de sus límites probados; una geografía global no implica un clúster.
No necesariamente. Cygnus está diseñada para trabajo conectado y rico en relaciones. Para los informes tabulares a gran escala, un data warehouse o una pila SQL madura puede seguir siendo la mejor opción, y Cygnus puede convivir con él.
Tráiganos una. Le mostraremos cómo la respondería un modelo conectado y qué haría falta.
O escríbanos a contact@natusai.com