NatusAI
Relacje
Klienci, urządzenia, umowy i zdarzenia powiązane bezpośrednio, dzięki czemu łatwo prześledzić własność, zależności i przyczyny.
 Połączony fundament danych · Warstwa 01 · Połączony fundamentPlanowane: v1
Cygnus to planowany fundament danych platformy NatusAI. Przechowuje razem zasoby, dokumenty, lokalizacje, pomiary i ich wzajemne relacje – dzięki temu ludzie i zatwierdzeni asystenci AI mogą odpowiadać na pytania, które wcześniej zajmowały dni.
Planowany zakres v1 i 25 kryteriów akceptacji →Roadmapa: późniejsze profile →
Odczyt z czujnika ma czas, miejsce, zasób i źródło. Umowa odnosi się do tego samego zasobu. Cygnus zachowuje te powiązania, więc odpowiedzi podążają za nimi, zamiast odtwarzać je za każdym razem.
Klienci, urządzenia, umowy i zdarzenia powiązane bezpośrednio, dzięki czemu łatwo prześledzić własność, zależności i przyczyny.
Kto obsługuje co, który raport opisuje który incydent: fakty powiązane z tym, co opisują.
Pozycje, trasy i obszary powiązane z zasobami, do których należą, oraz z ich historią.
Odczyty przechowywane obok zasobów, które opisują – od pojedynczej chwili po lata historii.
Informacje odnajdywane po treści, a następnie z odniesieniem do oryginalnego źródła.
Nazwy, identyfikatory i fragmenty tekstu w połączeniu z relacjami, miejscem i czasem.


Statek wpłynął w obszar sztormu o 14:00. Skorygowana pozycja dotarła o 14:10. Cygnus jest projektowany tak, by odtworzyć decyzję z 14:05 na podstawie tego, co było wtedy wiadomo, albo pokazać skorygowany obraz. Właśnie o taką historię pyta audytor lub organ nadzoru.
Cygnus ma łączyć własny typowany język programowania z przechowywaniem danych, wykonaniem i usługami. Logika biznesowa pracuje bezpośrednio na trwałych encjach i ich relacjach, co ogranicza tłumaczenie między wierszami bazy danych, obiektami aplikacji i odpowiedziami API.
Ten sam typowany model przenosi dane z trwałego magazynu do logiki aplikacji i kontraktów usług. Mniej mapowań to mniej miejsc, w których typy, nazwy pól i definicje relacji mogą się rozjechać.
Start od zindeksowanego punktu wejścia, przejście po potrzebnych relacjach i zawężenie według czasu, miejsca lub wyszukiwania. Zoptymalizowany model zapytań ma wykonywać tę pracę blisko magazynu danych i zwracać tylko żądany wynik.
Typowane funkcje stają się usługami aplikacji i autoryzowanymi narzędziami. HTTP/RPC, streaming, generowani klienci TypeScript i deskryptory MCP są częścią projektu backendu, co ogranicza liczbę osobnych warstw adapterów do utrzymania.
Dużego grafu nie trzeba w całości wczytywać do pamięci. Trwałe referencje pozwalają operacji rozwiązywać potrzebne węzły, strony indeksów i zakresy czasu dopiero wtedy, gdy są potrzebne.
Podgląd jednego statku nie powinien wymagać wczytania wszystkich statków, wszystkich dokumentów i całej historii pozycji. Selektywne przechodzenie grafu i ograniczone odczyty mają wiązać zużycie pamięci z wykonywaną pracą.
To droga do szybszych zapytań o połączone dane i mniejszego narzutu zasobów: mniej materializacji, mniej transferów między usługami i mniej zdublowanego kontekstu. Faktyczne korzyści zależą od grafu, indeksów, obciążenia i sprzętu.
Poglądowa ścieżka dostępu
01 / Trwały graf
Statek · Ładunek · Trasa · inne statki · inne ładunki · starsze zakresy pozostają na dysku.
Na początku dotykane są tylko referencje i zindeksowana selekcja.
02 / Właściwy zbiór roboczy
Wybrany statek → ładunek → żądana trasa
Rozwiązanie połączonych danych i okna czasowego, których używa ta operacja.
03 / Ograniczony wynik
Strona · próbka · strumień
Zwrócenie strony, próbki lub strumienia. Duże eksporty i przebudowy korzystają z ograniczonego przetwarzania lub trwałych zadań.
Systemy relacyjne dobrze sprawdzają się przy ustrukturyzowanych rekordach i raportowaniu SQL. Gdy połączona aplikacja zyskuje historię, mapy, wyszukiwanie semantyczne i AI, koszt często przesuwa się w stronę złączeń, mapowania obiektów i koordynacji dodatkowych usług. Cygnus ma ograniczać ten narzut w jednym programowalnym silniku.
| Wymiar | Magazyn tabelaryczny + stos aplikacyjny | Ujednolicony temporalny graf Cygnus (planowany) |
|---|---|---|
| Przechowywanie danych | Encje stają się wierszami; relacje korzystają z kluczy i często z tabel łączących. Kod aplikacji mapuje wiersze na obiekty. | Typowane encje i trwałe powiązania dzielą jeden model w magazynie, logice i usługach. |
| Zapytania o połączone dane | Złączenia odtwarzają relacje w chwili zapytania. Głębokie ścieżki mogą zwiększać złożoność zapytań i mapowania. | Zindeksowane punkty wejścia i przechodzenie grafu podążają za zapisanymi relacjami, z ograniczeniami czasowymi i przestrzennymi. |
| Pamięć i przenoszenie danych | Wydajne silniki już korzystają z indeksów i pamięci podręcznych; szerokie złączenia i przetwarzanie po stronie aplikacji mogą jednak tworzyć duże wyniki pośrednie. | Dane grafu rozwiązywane na żądanie; ograniczone zakresy, strony i strumienie zamiast materializacji całego połączonego zbioru danych. |
| Historia i korekty | Tabele historyczne, rozszerzenia temporalne lub modele zdarzeń trzeba zaprojektować i dopasować do zapytań aplikacji. | Stan temporalny i dostęp bitemporalny należą do modelu – z zachowaniem rozróżnienia między czasem obowiązywania a czasem wiedzy. |
| Geo, tekst i wektory | Rozszerzenia mogą dodać funkcje w jednej bazie danych; usługi specjalistyczne mogą wymagać własnych ścieżek tożsamości, indeksowania i synchronizacji. | Zasoby przestrzenne, szeregi czasowe, tekst i wektory łączą się z tymi samymi encjami i wersjonowanymi źródłami. |
| Języki zapytań i aplikacji | SQL plus kod aplikacji, biblioteki mapujące, a czasem osobne języki zapytań wyszukiwania lub grafu. | Jeden natywny typowany język i zoptymalizowany model zapytań przybliżają obliczenia do trwałych struktur grafu. |
| Utrzymanie i rozwój | Koordynacja schematów baz danych, mapowań, kontraktów usług i osobno utrzymywanych magazynów wyszukiwania. | Wspólne deskryptory typów i kontrakty usług ograniczają zdublowane definicje; migracje i zmiany indeksów podlegają jawnym regułom wersjonowania. |
| AI i kontrola dostępu | Zwykle dochodzi brama narzędzi i warstwa czatu, których uprawnienia trzeba następnie dopasować do wywoływanych ścieżek danych. | Natywne MCP i ograniczony kontrakt czatu korzystają z tych samych typowanych usług, z autoryzacją na ścieżkach przechowywania i wykonania. |
Jak to zmierzyć: zamierzona przewaga to szybsza praca na danych bogatych w relacje, z mniejszym narzutem mapowania, synchronizacji i zasobów. Warto mierzyć opóźnienie zapytań, szczytowe zużycie pamięci, operacje dyskowe, pozyskiwanie danych i nakład pracy na utrzymanie – na tym samym obciążeniu i sprzęcie. Przy dużej analityce tabelarycznej lub gdy potrzebne są określone rozszerzenia, lepszym wyborem może pozostać hurtownia danych lub dojrzały stos SQL.
Odpowiedź AI jest bardziej użyteczna, gdy potrafi połączyć właściwy dokument z właściwą encją, miejscem i momentem. Cygnus ma włączyć wyszukiwanie, wywoływalną logikę biznesową i zapisy rozmów do modelu backendu.
Model Context Protocol daje autoryzowanym agentom wykrywalny, typowany sposób korzystania z funkcji backendu. Wykrywanie i wykonywanie narzędzi podlega uprawnieniom wywołującego i korzysta z tych samych kontraktów usług co aplikacje.
Planowany, niezależny od dostawcy kontrakt czatu obejmuje wiadomości, zdarzenia strumieniowe, wywołania narzędzi, ustrukturyzowane wyniki oraz trwałe zapisy sesji i przebiegów. Lokalne lub zdalne integracje z modelami są dla danego wdrożenia wybierane i kwalifikowane jawnie.
Wyszukiwanie pełnotekstowe i wektorowe połączone z kontekstem grafowym, przestrzennym i historycznym. Odniesienia do wersji źródeł i wybranego kontekstu czasowego są zachowywane, by człowiek mógł sprawdzić dowody i zrozumieć, jak powstała odpowiedź.
Zasady dostępu do danych obowiązują przed ujawnieniem i rankingiem wyników wyszukiwania. Pobrane treści i wyniki modelu nie dają uprawnień do działania; chronione działania wymagają własnych uprawnień, a tam, gdzie to określono – decyzji człowieka.
„Jaki ładunek był wczoraj na statkach w obszarze sztormu i które raporty wyjaśniają ryzyko?”
To proponowane obciążenie morskie łączy całą architekturę. To samo podejście może łączyć urządzenia, telemetrię i utrzymanie w aplikacjach dla energetyki, produkcji czy infrastruktury.
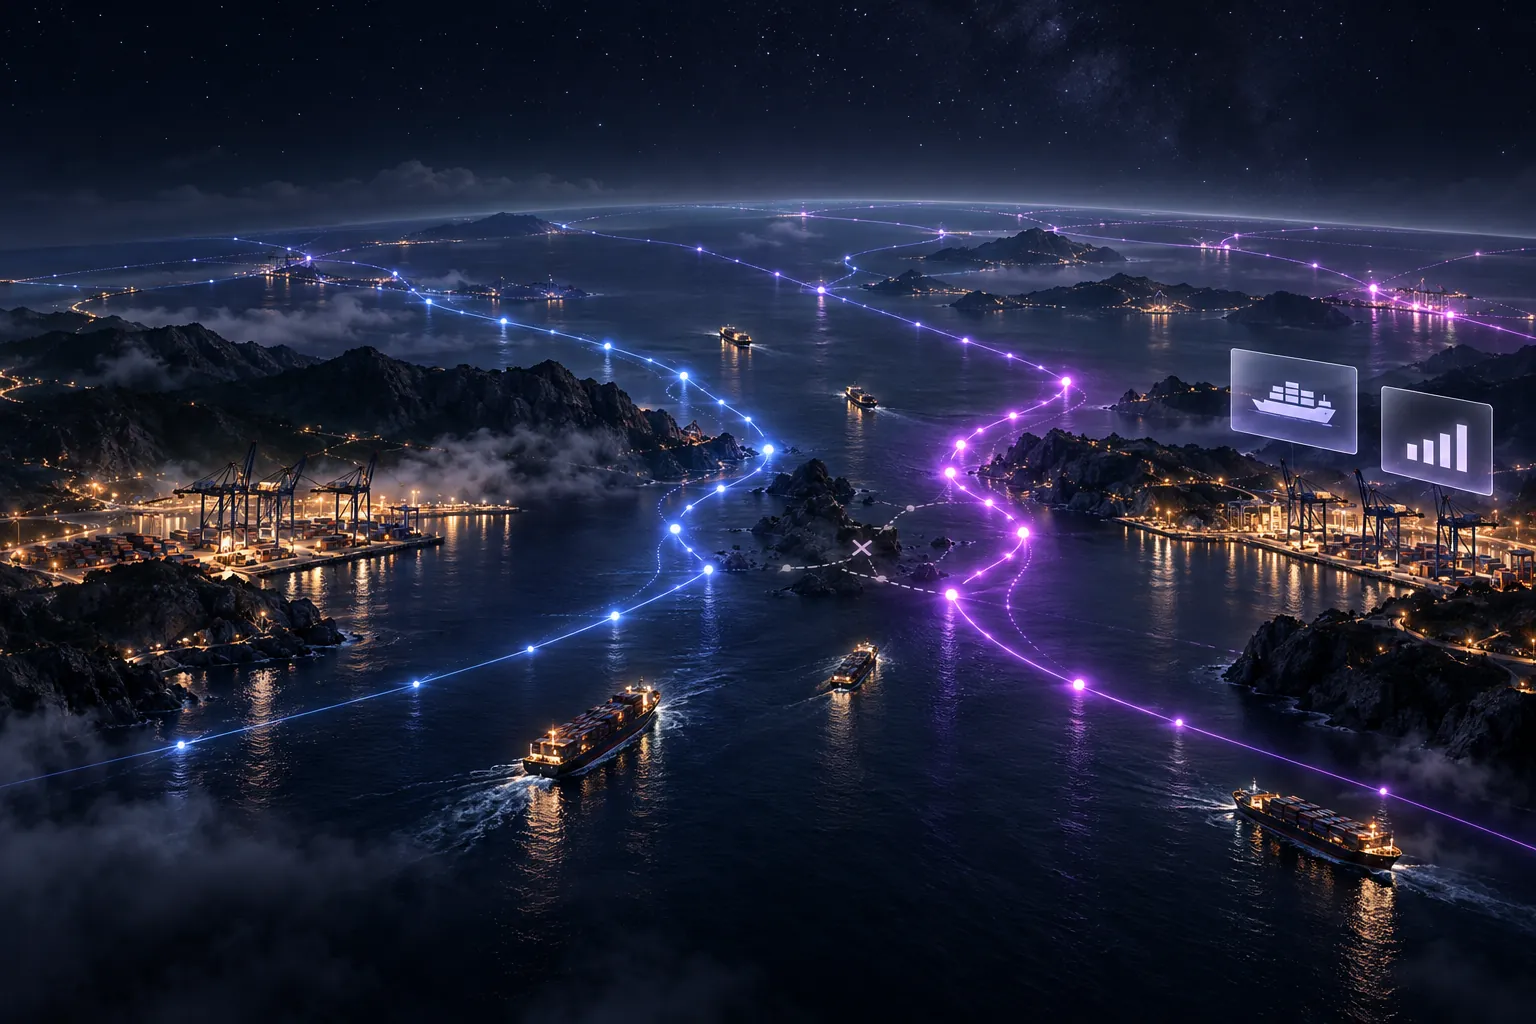
Jak powstaje odpowiedź
Wybór wczorajszego przedziału czasu oraz tego, czy pytanie korzysta z wiedzy dostępnej wtedy, czy z później skorygowanych dowodów.
Selekcja geoprzestrzenna i zakresy szeregów czasowych wskazują statki, których trasy przecięły obszar sztormu.
Przejście po historycznych relacjach statku z ładunkami, operatorami i portami, z rozwiązaniem potrzebnych części grafu.
Wyszukiwanie po słowach kluczowych i semantyczne w autoryzowanych wersjach dokumentów, powiązanych z wybranymi encjami i kontekstem czasowym.
Typowana usługa lub narzędzie MCP zwraca dowody. Czat może je objaśnić, zachowując źródła i właściwy kontekst.
Oddzielamy to, co sprawdzone, od tego, co dopiero powstaje, i oznaczamy jedno i drugie. Dla NatusAI Cygnus planowane jest pierwsze wydanie (v1).
Cygnus przechowuje dane i logikę biznesową. NatusAI Lyra je pokazuje, NatusAI Auriga i Aquila pozwalają AI z nimi pracować, NatusAI Orion buduje na nich aplikacje, NatusAI Draco je uruchamia, a NatusAI Gemini je odtwarza.
Czym jest Cygnus. Planowana programowalna temporalna grafowa baza danych: własny typowany język, zoptymalizowany model zapytań i środowisko uruchomieniowe backendu. Graf, dane geoprzestrzenne, wektory, semantyka triple-store, szeregi czasowe i wyszukiwanie pełnotekstowe współdzielą jeden model – z jedną tożsamością, jednym modelem transakcji i jedną granicą autoryzacji.
| Profil | Pierwsze wydanie | Granica |
|---|---|---|
| Wbudowany | Uwzględniony | Jeden proces aplikacji z lokalnym magazynem danych. |
| Deweloperski | Uwzględniony | Inicjalizacja pustego projektu i jawne tryby źródeł. |
| Produkcyjny, jeden serwer | Uwzględniony | Jeden węzeł; kopie zapasowe, odtwarzanie do punktu w czasie i zweryfikowane odtworzenie w zakresie. |
| Klaster | Wyłączony | Bez deklaracji shardingu, replikacji, rozproszonego przechodzenia grafu ani przełączania awaryjnego. |
| Izolowane obciążenie | Wyłączony | Brak osobno kwalifikowanego profilu izolowanego obciążenia. |
| Kryterium | Proponowany próg | Status |
|---|---|---|
| Produkcyjni partnerzy projektowi na obciążeniu referencyjnym | Co najmniej 3 | Jeszcze niespełnione |
| Produkcyjny system ewidencyjny z przechowywaną historią | Co najmniej 1, z historią 6+ miesięcy | Jeszcze niespełnione |
| Ciągłe pozyskiwanie pozycji, klasa referencyjna 32 vCPU | ≥ 100 000 raportów/s | Jeszcze niespełnione |
| Statki w obrębie wielokąta przy 250 000 bieżących pozycji | p99 ≤ 150 ms | Jeszcze niespełnione |
| Hybrydowe wyszukiwanie top-20 w 5 000 000 dokumentów | p99 ≤ 300 ms | Jeszcze niespełnione |
| Poprawność przetwarzania out-of-core | Zbiór danych ≥ 24 × RAM | Jeszcze niespełnione |
| Narzut autoryzacji na poziomie elementów | ≤ 2 × polityka zgrubna | Jeszcze niespełnione |
| Utracone potwierdzone zatwierdzenia transakcji na jednym serwerze | Zero | Jeszcze niespełnione |
| Zaplanowane testy zweryfikowanego odtworzenia | 100% zaliczonych | Jeszcze niespełnione |
| Oceny pustych projektów prowadzone przez agentów, bez poprawek ze strony człowieka | ≥ 70% zakończonych sukcesem | Jeszcze niespełnione |
Działa na Państwa serwerach jako jeden system, bez osobnych usług wyszukiwania, grafu i szeregów czasowych do licencjonowania i zabezpieczania.
Odpowiedzi zachowują odniesienia do wersji źródła i momentu w czasie, z których skorzystały.
Zasady dostępu do danych obowiązują, zanim cokolwiek zostanie pokazane lub uszeregowane. Pobrany tekst nigdy nie daje AI uprawnień do działania.
Zweryfikowane odtworzenie i odtwarzanie do punktu w czasie to wymagania wydania, a nie opcje.
Problemy, podejścia i użyteczne wyniki z naszych historii branżowych i architektur referencyjnych. Każdy przykład wskazuje wymiary, dzięki którym problem pasuje do planowanego ujednoliconego modelu Cygnus.
01 · Bankowość i usługi finansowe
Rachunki → Transakcje → Dochodzenie
Dopasowanie do CygnusGrafTrójkiHistoria temporalnaPełny tekst
02 · Energetyka i media
Zasoby sieciowe → Odczyty liczników → Utrzymanie
Dopasowanie do CygnusGrafDane geoprzestrzenneSzeregi czasoweHistoria temporalna
03 · Produkcja
Urządzenie → Historia czujników → Interwencja
Dopasowanie do CygnusGrafSzeregi czasoweHistoria temporalna
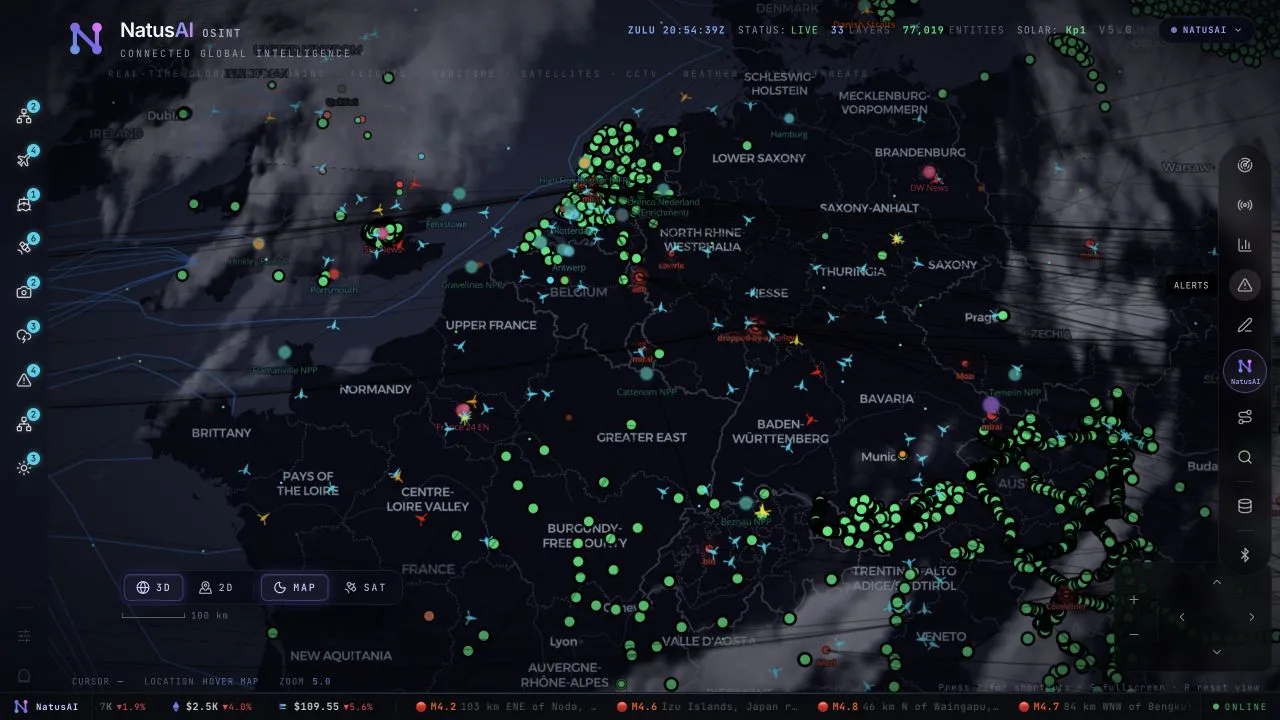
04 · OSINT
Miejsca i zdarzenia → Raporty źródłowe → Ocena
Dopasowanie do CygnusDane geoprzestrzenneGrafPełny tekstHistoria temporalna
05 · Planowanie fotowoltaiki i infrastruktury
Budynki → Warunki nasłonecznienia → Scenariusze
Dopasowanie do CygnusDane geoprzestrzenneGrafSzeregi czasowe
06 · Telekomunikacja
Klient → Zgłoszenie → Przekazanie do człowieka
Dopasowanie do CygnusGrafPełny tekstHistoria temporalnaCzat
07 · Handel i łańcuchy dostaw
Przepływy handlowe → Zależności → Zakłócenie
Dopasowanie do CygnusGrafDane geoprzestrzenneHistoria temporalnaCzat
Te historie opisują projekty, zbadane procesy i architektury referencyjne. Etykiety „Dopasowanie do Cygnus” odnoszą je do planowanego produktu; nie oznaczają wydanego wdrożenia Cygnus.

Fundament w parze
NatusAI Lyra dostarcza komponenty webowe wielokrotnego użytku dla map, grafów, wyszukiwania i procesów aplikacyjnych. Szersza integracja z Orion i Cygnus jest częścią wizji platformy. Więcej o NatusAI Lyra
Komponenty interfejsu wielokrotnego użytku dla dashboardów, map, dokumentów i rozmów z AI.
Dokumenty zamienione w wiedzę, którą można cytować – ze źródłem w zasięgu jednego kliknięcia.
Asystenci AI i narzędzia działające w granicach uprawnień i budżetów ustalonych przez Państwa zespół.
Krótkie odpowiedzi dla decydentów. Szczegóły dla Państwa zespołu technicznego znajdują się w rozwijanej sekcji powyżej.
Jeszcze nie. Cygnus jest planowany w pierwszym wydaniu, które zostanie zaakceptowane dopiero po przejściu zdefiniowanych testów akceptacyjnych. Ten sam silnik, na którym opierają się nasze projekty u klientów, jest już sprawdzony we wdrożeniach, a nasz zespół buduje na nim już dziś.
Nie. Pierwsze wydanie jest przeznaczone na jeden serwer. Model danych obejmujący cały świat może działać na jednym węźle w granicach przetestowanych limitów; globalny zasięg geograficzny nie oznacza konieczności klastra.
Niekoniecznie. Cygnus jest projektowany do pracy na połączonych danych, w której dominują relacje. Przy dużym raportowaniu tabelarycznym lepszym wyborem może pozostać hurtownia danych lub dojrzały stos SQL, a Cygnus może działać obok nich.
Wystarczy jedno takie pytanie. Pokażemy, jak odpowiedziałby na nie połączony model danych i czego by to wymagało.
Można też napisać na adres contact@natusai.com