NatusAI
Beziehungen
Kunden, Anlagen, Verträge und Ereignisse direkt verknüpft – so lassen sich Zuständigkeiten, Abhängigkeiten und Ursachen leicht nachvollziehen.
 Vernetztes Datenfundament · Ebene 01 · Vernetztes FundamentGeplant: v1
Cygnus ist das geplante Datenfundament der NatusAI-Plattform. Es hält Anlagen, Dokumente, Standorte, Messwerte und ihre Beziehungen zusammen – damit Menschen und freigegebene KI-Assistenten Fragen beantworten können, die früher Tage dauerten.
Geplanter Umfang v1 & 25 Abnahmekriterien →Roadmap: spätere Profile →
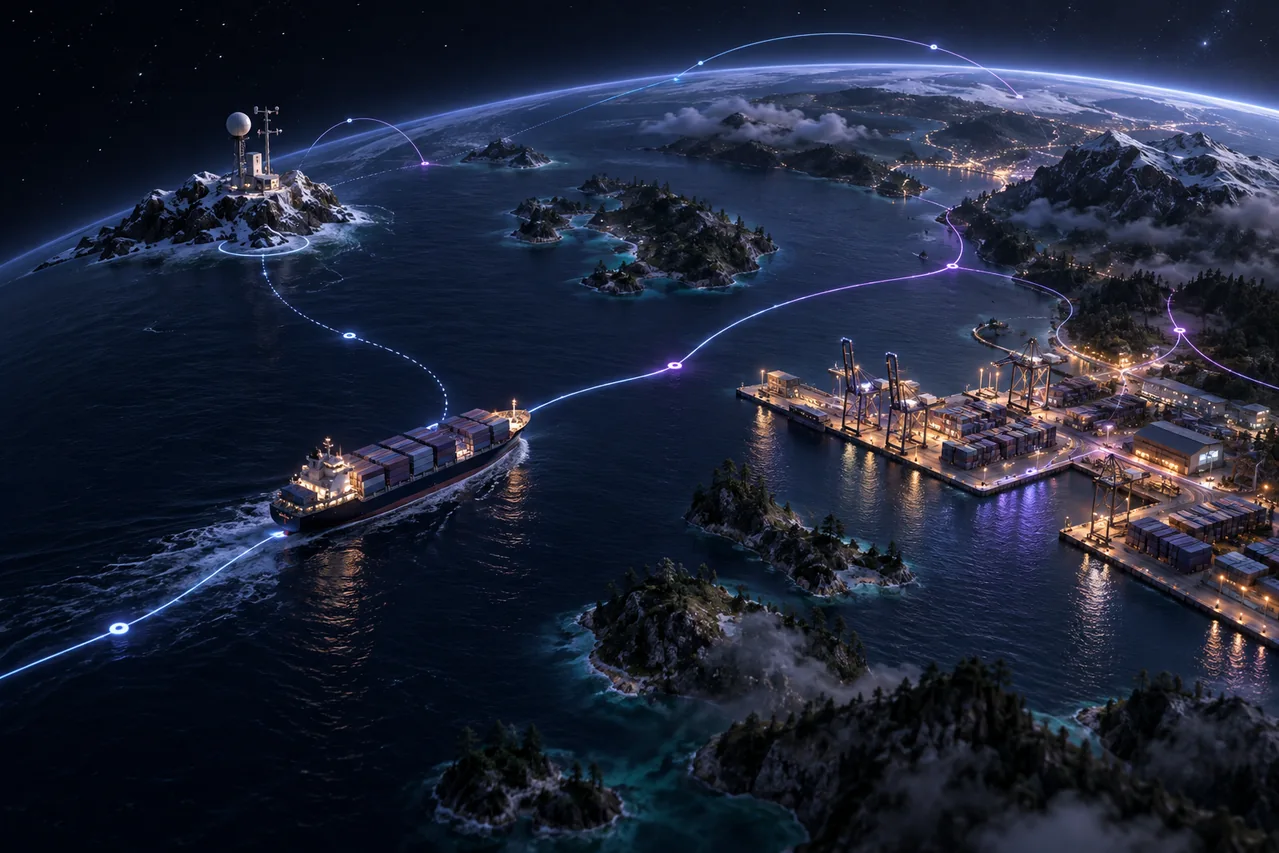
Ein Sensorwert hat einen Zeitpunkt, einen Ort, eine Anlage und eine Quelle. Ein Vertrag verweist auf dieselbe Anlage. Cygnus bewahrt diese Verbindungen, sodass Antworten ihnen folgen, statt sie jedes Mal neu herzustellen.
Kunden, Anlagen, Verträge und Ereignisse direkt verknüpft – so lassen sich Zuständigkeiten, Abhängigkeiten und Ursachen leicht nachvollziehen.
Wer was betreibt, welcher Bericht welchen Vorfall beschreibt: Fakten, verknüpft mit dem, was sie beschreiben.
Positionen, Bewegungsspuren und Gebiete, verknüpft mit den zugehörigen Anlagen und deren Historie.
Messwerte direkt bei den Anlagen, die sie beschreiben – vom einzelnen Moment bis zu Jahren an Historie.
Informationen nach ihrem Inhalt finden und dann bis zur Originalquelle zurückverfolgen.
Namen, Kennungen und Textstellen, kombiniert mit Beziehungen, Ort und Zeit.


Ein Schiff fuhr um 14:00 Uhr in ein Sturmgebiet ein. Um 14:10 Uhr traf eine korrigierte Position ein. Cygnus ist darauf ausgelegt, die Entscheidung von 14:05 Uhr mit dem damaligen Wissensstand zu rekonstruieren – oder das korrigierte Bild zu zeigen. Genau diese Historie verlangen Prüfer und Aufsicht.
Cygnus soll eine eigene typisierte Programmiersprache mit Speicherung, Ausführung und Diensten verbinden. Die Geschäftslogik arbeitet direkt mit persistenten Entitäten und ihren Beziehungen – das reduziert die Übersetzung zwischen Datenbankzeilen, Anwendungsobjekten und API-Antworten.
Dasselbe typisierte Modell trägt die Daten vom dauerhaften Speicher in die Anwendungslogik und die Dienstverträge. Weniger Mappings bedeuten weniger Stellen, an denen Typen, Feldnamen und Beziehungsdefinitionen auseinanderlaufen.
Beginnen Sie an einem indizierten Einstiegspunkt, folgen Sie den benötigten Beziehungen und schränken Sie nach Zeit, Raum oder Suche ein. Das optimierte Abfragemodell soll diese Arbeit nah am Speicher erledigen und nur das angeforderte Ergebnis zurückgeben.
Typisierte Funktionen werden zu Anwendungsdiensten und freigegebenen Tools. HTTP/RPC, Streaming, generierte TypeScript-Clients und MCP-Deskriptoren sind Teil des Backend-Designs – so müssen weniger separate Adapterschichten gepflegt werden.
Ein großer Graph muss nicht vollständig in den Arbeitsspeicher geladen werden. Persistente Referenzen lassen eine Operation die relevanten Knoten, Indexseiten und Zeitbereiche erst dann auflösen, wenn sie gebraucht werden.
Wer ein Schiff betrachtet, sollte nicht jedes Schiff, jedes Dokument und die gesamte Positionshistorie laden müssen. Selektive Traversierung und begrenzte Lesezugriffe sollen den Speicherverbrauch an die tatsächlich ausgeführte Arbeit koppeln.
Das ist der Weg zu schnelleren vernetzten Abfragen und geringerem Ressourcenaufwand: weniger Materialisierung, weniger Transfers zwischen Diensten und weniger duplizierter Kontext. Die tatsächlichen Gewinne hängen von Graph, Indizes, Workload und Hardware ab.
Illustrativer Zugriffspfad
01 / Dauerhafter Graph
Schiff · Ladung · Route · andere Schiffe · andere Ladung · ältere Zeiträume bleiben auf der Festplatte.
Zunächst werden nur Referenzen und eine indizierte Auswahl berührt.
02 / Relevanter Arbeitsbestand
Ausgewähltes Schiff → Ladung → angeforderte Route
Die vernetzten Daten und das Zeitfenster auflösen, die diese Operation nutzt.
03 / Begrenztes Ergebnis
Seite · Stichprobe · Stream
Eine Seite, eine Stichprobe oder einen Stream zurückgeben. Große Exporte und Neuaufbauten nutzen begrenzte Verarbeitung oder dauerhafte Jobs.
Relationale Systeme eignen sich gut für strukturierte Datensätze und SQL-Reporting. Kommen in einer vernetzten Anwendung Historie, Karten, semantisches Retrieval und KI hinzu, verlagern sich die Kosten oft auf Joins, Objekt-Mapping und die Koordination zusätzlicher Dienste. Cygnus soll diesen Mehraufwand in einer programmierbaren Engine verringern.
| Dimension | Tabellarische Speicherung + Anwendungs-Stack | Einheitlicher temporaler Graph von Cygnus (geplant) |
|---|---|---|
| Datenspeicherung | Entitäten werden zu Zeilen; Beziehungen nutzen Schlüssel und oft Verknüpfungstabellen. Anwendungscode bildet Zeilen auf Objekte ab. | Typisierte Entitäten und persistente Verknüpfungen teilen ein Modell über Speicherung, Logik und Dienste hinweg. |
| Vernetzte Abfragen | Joins rekonstruieren Beziehungen zur Abfragezeit. Tiefe Pfade können die Komplexität von Abfragen und Mapping erhöhen. | Indizierte Einstiegspunkte und Graph-Traversierung folgen gespeicherten Beziehungen, mit zeitlichen und räumlichen Einschränkungen. |
| Speicher & Datenbewegung | Effiziente Engines nutzen bereits Indizes und Caches; breite Joins und Verarbeitung auf Anwendungsseite können dennoch große Zwischenergebnisse erzeugen. | Graphdaten bei Bedarf auflösen; begrenzte Bereiche, Seiten und Streams nutzen, statt den gesamten vernetzten Datenbestand zu materialisieren. |
| Historie & Korrekturen | Historientabellen, temporale Erweiterungen oder Ereignismodelle müssen entworfen und auf die Abfragen der Anwendung abgestimmt werden. | Zeitlicher Zustand und bitemporaler Zugriff gehören zum Modell – die Unterscheidung zwischen Gültigkeitszeit und Wissenszeit bleibt erhalten. |
| Geodaten, Text & Vektoren | Erweiterungen können Fähigkeiten in einer Datenbank ergänzen; spezialisierte Dienste brauchen unter Umständen eigene Identitäts-, Indizierungs- und Synchronisationspfade. | Geodaten-, Zeitreihen-, Text- und Vektorressourcen sind mit denselben Entitäten und versionierten Quellen verbunden. |
| Abfrage- & Anwendungssprachen | SQL plus Anwendungscode, Mapping-Bibliotheken und manchmal separate Such- oder Graph-Abfragesprachen. | Eine native typisierte Sprache und ein optimiertes Abfragemodell bringen die Berechnung nah an persistente Graphstrukturen. |
| Wartung & Weiterentwicklung | Datenbankschemas, Mappings, Dienstverträge und separat betriebene Retrieval-Speicher müssen koordiniert werden. | Gemeinsame Typdeskriptoren und Dienstverträge reduzieren doppelte Definitionen; Migrationen und Indexänderungen folgen einem expliziten Versionsverhalten. |
| KI & Zugriffskontrolle | Meist kommen ein Tool-Gateway und eine Chat-Schicht hinzu, deren Berechtigungen dann mit den aufgerufenen Datenpfaden abgeglichen werden müssen. | Natives MCP und ein begrenzter Chat-Vertrag nutzen dieselben typisierten Dienste, mit Autorisierung in den Speicher- und Ausführungspfaden. |
So messen Sie es: Der angestrebte Vorteil ist schnellere beziehungsintensive Arbeit mit weniger Aufwand für Mapping, Synchronisation und Ressourcen. Messen Sie Abfragelatenz, Spitzenspeicher, Festplatten-I/O, Aufnahme und Wartungsaufwand auf derselben Workload und Hardware. Für große tabellarische Analysen oder benötigte Erweiterungen kann ein Data Warehouse oder ein ausgereifter SQL-Stack die bessere Wahl bleiben.
Eine KI-Antwort wird nützlicher, wenn sie das richtige Dokument mit der richtigen Entität, dem richtigen Ort und dem richtigen Zeitpunkt verbinden kann. Cygnus soll Retrieval, aufrufbare Geschäftslogik und Gesprächsprotokolle in das Backend-Modell holen.
Das Model Context Protocol gibt autorisierten Agenten einen auffindbaren, typisierten Weg, Backend-Funktionen zu nutzen. Auffinden und Ausführen von Tools folgen den Berechtigungen des Aufrufers – mit denselben Dienstverträgen, die auch Anwendungen nutzen.
Der geplante anbieterneutrale Chat-Vertrag umfasst Nachrichten, Streaming-Ereignisse, Tool-Aufrufe, strukturierte Ausgabe und dauerhafte Sitzungs- und Laufprotokolle. Lokale oder entfernte Modellanbindungen werden für die jeweilige Installation explizit ausgewählt und qualifiziert.
Volltext- und Vektor-Retrieval mit Graph-, Geo- und Historienkontext kombinieren. Verweise auf Quellversionen und den gewählten Zeitkontext bleiben erhalten – so kann ein Mensch die Belege prüfen und nachvollziehen, wie eine Antwort entstanden ist.
Datenzugriffsregeln greifen vor Offenlegung und Such-Ranking. Abgerufene Inhalte und Modellausgaben erteilen keine Berechtigung zu handeln; geschützte Aktionen erfordern eine eigene Befugnis und, wo festgelegt, eine menschliche Entscheidung.
„Welche Ladung war gestern auf Schiffen im Sturmgebiet – und welche Berichte erklären das Risiko?“
Diese vorgeschlagene maritime Workload führt die Architektur zusammen. Derselbe Ansatz kann Anlagen, Telemetrie und Wartung in Anwendungen für Energie, Fertigung oder Infrastruktur verbinden.
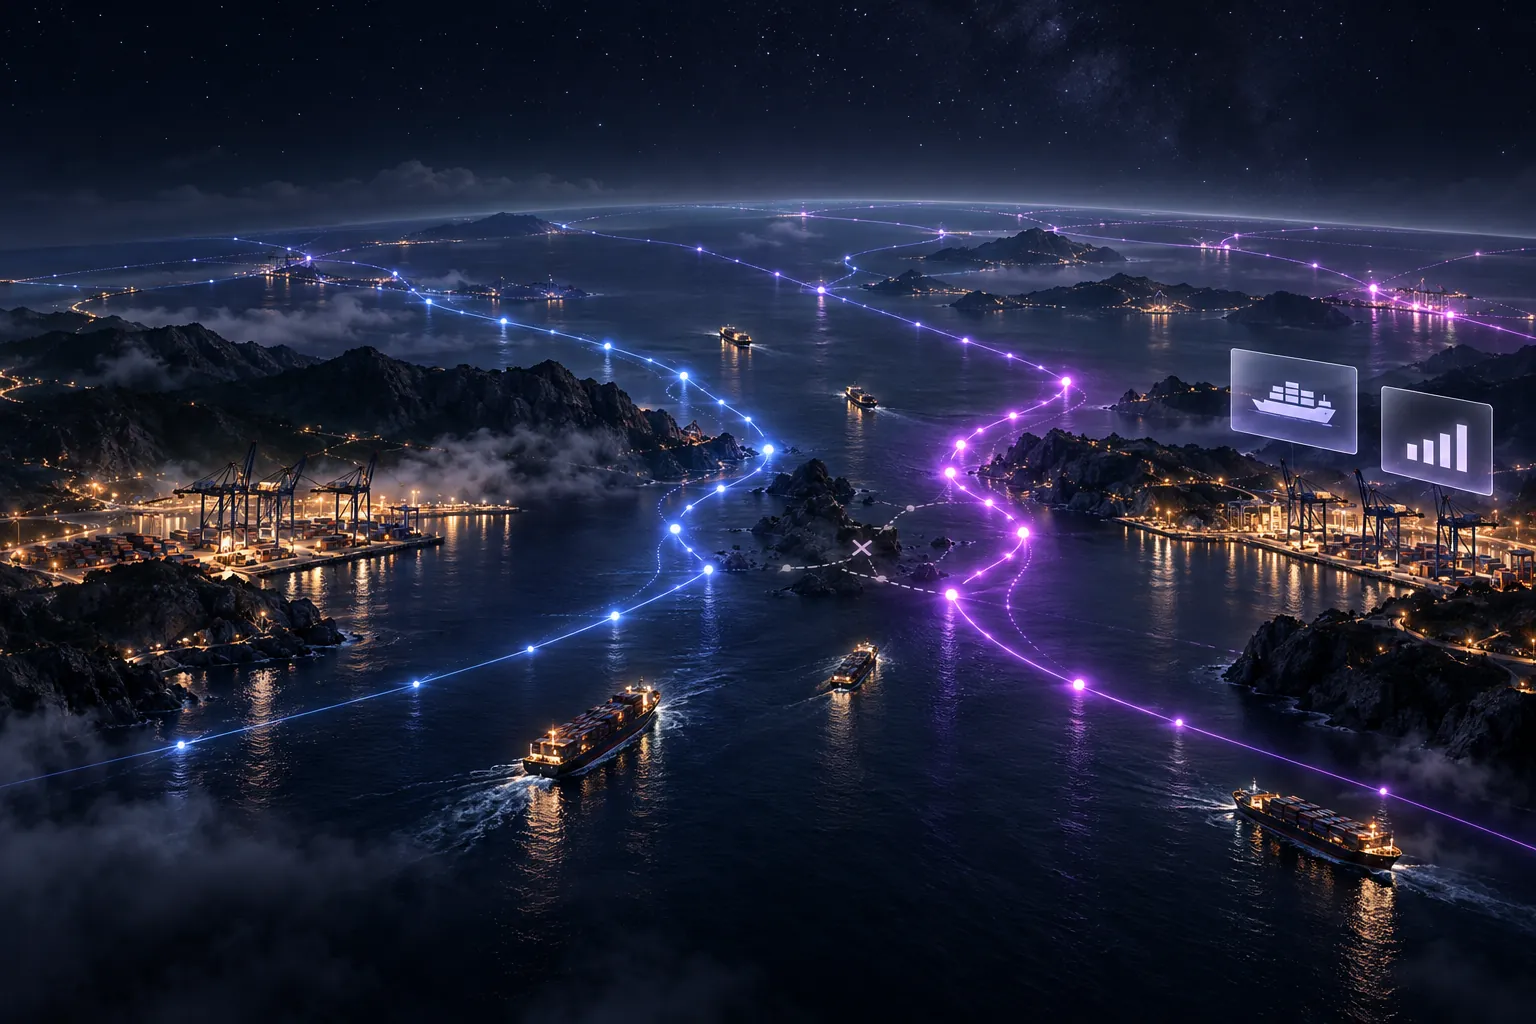
So entsteht die Antwort
Den gestrigen Zeitraum wählen – und ob die Frage den damaligen Wissensstand oder später korrigierte Belege verwendet.
Mit Geodatenauswahl und Zeitreihenbereichen die Schiffe ermitteln, deren Routen das Sturmgebiet geschnitten haben.
Die historischen Beziehungen des Schiffs zu Ladung, Betreibern und Häfen traversieren und dabei nur die benötigten Teile des Graphen auflösen.
Stichwort- und semantische Suche über freigegebene Dokumentversionen kombinieren, verknüpft mit den ausgewählten Entitäten und dem Zeitkontext.
Ein typisierter Dienst oder ein MCP-Tool liefert die Belege. Der Chat kann sie erläutern und behält dabei die Quellen und den relevanten Kontext bei.
Wir trennen, was belegt ist, von dem, was noch kommt, und kennzeichnen beides. NatusAI Cygnus ist für die Erstversion (v1) geplant.
Cygnus hält die Daten und die Geschäftslogik. NatusAI Lyra stellt sie dar, NatusAI Auriga und Aquila lassen die KI damit arbeiten, NatusAI Orion baut Anwendungen darauf, NatusAI Draco betreibt sie und NatusAI Gemini stellt sie wieder her.
Was Cygnus ist. Eine geplante programmierbare temporale Graphdatenbank: mit eigener typisierter Sprache, einem optimierten Abfragemodell und einer Backend-Laufzeitumgebung. Graph, Geodaten, Vektoren, Triple-Store-Semantik, Zeitreihen und Volltextsuche teilen ein Modell – mit einer Identität, einem Transaktionsmodell und einer Autorisierungsgrenze.
| Profil | Erstversion | Abgrenzung |
|---|---|---|
| Embedded | Enthalten | Ein Anwendungsprozess mit lokalem Speicher. |
| Entwicklung | Enthalten | Bootstrap leerer Projekte und explizite Quellmodi. |
| Produktivbetrieb, ein Server | Enthalten | Ein Knoten; Backup, Point-in-Time-Recovery und geprüfte Wiederherstellung im Umfang. |
| Cluster | Nicht enthalten | Keine Aussage zu Sharding, Replikation, verteilter Traversierung oder Failover. |
| Isolierte Workloads | Nicht enthalten | Kein separat qualifiziertes Profil für isolierte Workloads. |
| Kriterium | Vorgeschlagener Schwellenwert | Status |
|---|---|---|
| Designpartner im Produktivbetrieb mit der Referenz-Workload | Mindestens 3 | Noch nicht bestanden |
| Produktives führendes System mit aufbewahrter Historie | Mindestens 1, mit 6+ Monaten Historie | Noch nicht bestanden |
| Dauerhafte Positionsaufnahme, Referenzklasse 32 vCPU | ≥ 100.000 Meldungen/s | Noch nicht bestanden |
| Schiffe innerhalb eines Polygons bei 250.000 Live-Positionen | p99 ≤ 150 ms | Noch nicht bestanden |
| Hybrides Top-20-Retrieval über 5 Millionen Dokumente | p99 ≤ 300 ms | Noch nicht bestanden |
| Korrektheit bei Out-of-Core-Betrieb | Datensatz ≥ 24 × RAM | Noch nicht bestanden |
| Mehraufwand der Autorisierung auf Elementebene | ≤ 2 × grobgranulare Richtlinie | Noch nicht bestanden |
| Verlorene bestätigte Commits auf einem Server | Null | Noch nicht bestanden |
| Geplante Tests der geprüften Wiederherstellung | 100 % bestanden | Noch nicht bestanden |
| Agentengesteuerte Evaluierungen leerer Projekte ohne menschliche Nachbesserung | ≥ 70 % erfolgreich | Noch nicht bestanden |
Läuft auf Ihren Servern als ein System – ohne separate Such-, Graph- und Zeitreihendienste, die lizenziert und abgesichert werden müssen.
Antworten behalten Verweise auf die verwendete Quellversion und den Zeitpunkt.
Datenzugriffsregeln greifen, bevor etwas angezeigt oder gerankt wird. Abgerufener Text erteilt einer KI niemals die Berechtigung zu handeln.
Geprüfte Wiederherstellung und Point-in-Time-Recovery sind Release-Voraussetzungen, keine Optionen.
Die Probleme, Ansätze und nützlichen Ergebnisse aus unseren Branchenbeispielen und Referenzarchitekturen. Jedes Beispiel zeigt die Dimensionen, die das Problem für das geplante einheitliche Cygnus-Modell geeignet machen.
01 · Banken & Finanzdienstleistungen
Konten → Transaktionen → Ermittlung
Cygnus-EignungGraphTripelZeitliche HistorieVolltext
02 · Energie & Versorgung
Netzbetriebsmittel → Zählerwerte → Wartung
Cygnus-EignungGraphGeodatenZeitreihenZeitliche Historie
03 · Fertigung
Anlage → Sensorhistorie → Eingriff
Cygnus-EignungGraphZeitreihenZeitliche Historie
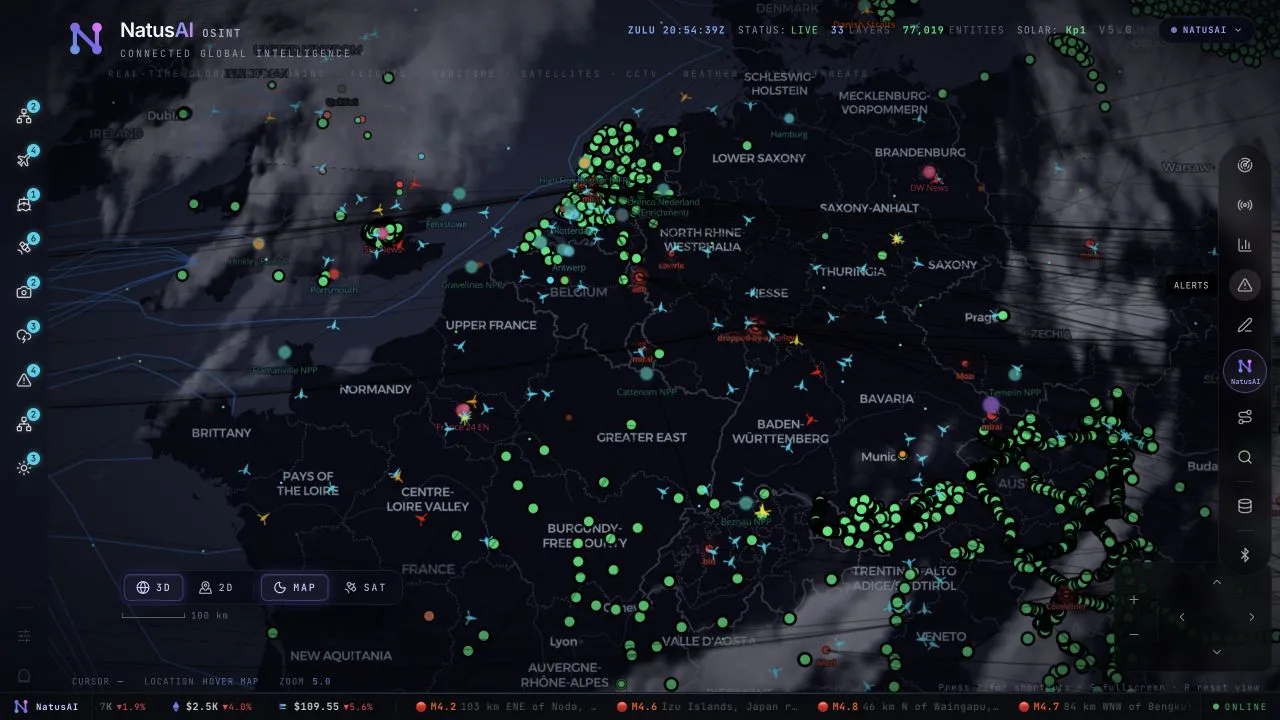
04 · OSINT
Orte & Ereignisse → Quellberichte → Bewertung
Cygnus-EignungGeodatenGraphVolltextZeitliche Historie
05 · Solar- & Infrastrukturplanung
Gebäude → Solarbedingungen → Szenarien
Cygnus-EignungGeodatenGraphZeitreihen
06 · Telekommunikation
Kunde → Serviceanfrage → Übergabe an Menschen
Cygnus-EignungGraphVolltextZeitliche HistorieChat
07 · Handel & Lieferketten
Handelsströme → Abhängigkeiten → Störung
Cygnus-EignungGraphGeodatenZeitliche HistorieChat
Diese Beispiele beschreiben Projekte, untersuchte Abläufe und Referenzarchitekturen. Die Cygnus-Eignungslabels ordnen sie dem geplanten Produkt zu; sie belegen keine veröffentlichte Cygnus-Installation.

Zwei Bausteine, ein Fundament
NatusAI Lyra liefert wiederverwendbare Webkomponenten für Karten, Graphen, Suche und Anwendungsabläufe. Die weitergehende Integration von Orion und Cygnus ist Teil der Plattformvision. NatusAI Lyra entdecken
Wiederverwendbare UI-Komponenten für Dashboards, Karten, Dokumente und KI-Dialoge.
Machen Sie Dokumente zu zitierfähigem Wissen – die Quelle ist nur einen Klick entfernt.
KI-Assistenten und Werkzeuge, die innerhalb der Berechtigungen und Budgets arbeiten, die Ihre Mitarbeitenden festlegen.
Kurze Antworten für Entscheider. Details für Ihr technisches Team finden Sie im aufklappbaren Bereich oben.
Noch nicht. Cygnus ist für eine Erstversion geplant, die erst abgenommen wird, wenn die definierten Abnahmetests bestanden sind. Dieselbe Engine wie in unseren Kundenprojekten hat sich bereits in der Praxis bewährt, und unser Team baut heute darauf.
Nein. Die Erstversion zielt auf einen einzelnen Server. Ein weltweites Datenmodell kann innerhalb seiner getesteten Grenzen auf einem Knoten laufen; globale Geografie bedeutet nicht automatisch einen Cluster.
Nicht unbedingt. Cygnus ist für vernetzte, beziehungsreiche Aufgaben ausgelegt. Für große tabellarische Berichte kann ein Data Warehouse oder ein ausgereifter SQL-Stack die bessere Wahl bleiben – Cygnus kann daneben laufen.
Bringen Sie sie mit. Wir zeigen Ihnen, wie ein vernetztes Modell sie beantworten würde – und was dafür nötig wäre.
Oder schreiben Sie an contact@natusai.com