NatusAI
Relations
Clients, équipements, contrats et événements reliés directement, pour suivre facilement propriétés, dépendances et causes.
 Socle de données connecté · Couche 01 · Socle connectéV1 prévue
Cygnus est le socle de données prévu de la plateforme NatusAI. Il réunit actifs, documents, lieux, mesures et leurs relations, pour que les personnes et les assistants IA approuvés puissent répondre à des questions qui demandaient auparavant des jours.
Périmètre prévu de la v1 et 25 critères d’acceptation →Feuille de route : profils ultérieurs →
Une mesure de capteur a une heure, un lieu, un actif et une source. Un contrat fait référence au même actif. Cygnus conserve ces liens, pour que les réponses les suivent au lieu de les reconstruire à chaque fois.
Clients, équipements, contrats et événements reliés directement, pour suivre facilement propriétés, dépendances et causes.
Qui exploite quoi, quel rapport décrit quel incident : des faits rattachés aux éléments qu’ils décrivent.
Positions, trajectoires et zones reliées aux actifs auxquels elles appartiennent, et à leur historique.
Des relevés conservés à côté des actifs qu’ils décrivent, d’un instant à des années d’historique.
Trouver une information d’après ce qu’elle dit, puis remonter jusqu’à la source d’origine.
Noms, identifiants et passages, combinés aux relations, au lieu et au temps.


Un navire est entré dans une zone de tempête à 14 h 00. Une position corrigée est arrivée à 14 h 10. Cygnus est conçu pour reconstituer la décision de 14 h 05 avec ce qui était connu à ce moment-là, ou pour montrer la situation corrigée. C’est exactement l’historique que demande un auditeur ou une autorité de contrôle.
Cygnus doit associer son propre langage de programmation typé au stockage, à l’exécution et aux services. La logique métier manipule directement les entités persistantes et leurs relations, ce qui réduit les traductions entre lignes de base de données, objets applicatifs et réponses d’API.
Le même modèle typé porte les données du stockage durable jusqu’à la logique applicative et aux contrats de service. Moins de correspondances, c’est moins d’endroits où types, noms de champs et définitions de relations peuvent diverger.
Partez d’un point d’entrée indexé, suivez les relations dont vous avez besoin et filtrez par le temps, l’espace ou la recherche. Le modèle de requête optimisé vise à effectuer ce travail au plus près du stockage et à ne renvoyer que le résultat demandé.
Les fonctions typées deviennent des services applicatifs et des outils autorisés. HTTP/RPC, streaming, clients TypeScript générés et descripteurs MCP font partie de la conception du backend, ce qui réduit le nombre de couches d’adaptation distinctes à maintenir.
Un grand graphe n’a pas besoin d’être chargé entièrement en mémoire. Les références persistantes permettent à une opération de résoudre les nœuds, pages d’index et plages temporelles pertinents au moment où elle en a besoin.
Consulter un navire ne devrait pas obliger à charger tous les navires, tous les documents et tout l’historique des positions. Le parcours sélectif et les lectures bornées sont conçus pour que l’usage de la mémoire reste lié au travail effectué.
C’est la voie vers des requêtes connectées plus rapides et une moindre consommation de ressources : moins de matérialisation, moins de transferts entre services et moins de contexte dupliqué. Les gains réels dépendent du graphe, des index, de la charge de travail et du matériel.
Chemin d’accès illustratif
01 / Graphe durable
Navire · Cargaison · Route · autres navires · autres cargaisons · les plages plus anciennes restent sur disque.
Seules les références et une sélection indexée sont sollicitées au départ.
02 / Ensemble de travail pertinent
Navire sélectionné → cargaison → trajectoire demandée
Résoudre les données connectées et la fenêtre temporelle utilisées par cette opération.
03 / Résultat borné
Page · échantillon · flux
Renvoyer une page, un échantillon ou un flux. Les exports volumineux et les reconstructions s’appuient sur un traitement borné ou sur des tâches durables.
Les systèmes relationnels conviennent bien aux enregistrements structurés et au reporting SQL. Lorsqu’une application connectée ajoute historique, cartes, recherche sémantique et IA, le coût se déplace souvent vers les jointures, la correspondance objet et la coordination de services supplémentaires. Cygnus est conçu pour réduire cette charge au sein d’un moteur programmable unique.
| Dimension | Stockage tabulaire + pile applicative | Graphe temporel unifié Cygnus (prévu) |
|---|---|---|
| Stockage des données | Les entités deviennent des lignes ; les relations passent par des clés et souvent des tables de liaison. Le code applicatif convertit les lignes en objets. | Entités typées et liens persistants partagent un même modèle pour le stockage, la logique et les services. |
| Requêtes connectées | Les jointures reconstruisent les relations au moment de la requête. Les chemins profonds peuvent complexifier requêtes et correspondances. | Points d’entrée indexés et parcours de graphe suivent les relations stockées, avec des contraintes temporelles et spatiales. |
| Mémoire et mouvements de données | Les moteurs performants utilisent déjà index et caches ; les jointures larges et le traitement côté application peuvent tout de même produire des résultats intermédiaires volumineux. | Résoudre les données du graphe à la demande ; utiliser des plages bornées, des pages et des flux plutôt que de matérialiser l’ensemble des données connectées. |
| Historique et corrections | Tables d’historique, extensions temporelles ou modèles d’événements doivent être conçus et alignés sur les requêtes de l’application. | L’état temporel et l’accès bitemporel font partie du modèle, qui préserve la distinction entre temps de validité et temps de connaissance. |
| Géo, texte et vecteurs | Des extensions peuvent ajouter des capacités dans une même base ; les services spécialisés peuvent nécessiter leurs propres identités, index et chemins de synchronisation. | Ressources spatiales, séries temporelles, texte et vecteurs se rattachent aux mêmes entités et aux mêmes sources versionnées. |
| Langages de requête et d’application | SQL plus code applicatif, bibliothèques de correspondance et parfois des langages de requête distincts pour la recherche ou le graphe. | Un langage typé natif et un modèle de requête optimisé rapprochent le calcul des structures de graphe persistantes. |
| Maintenance et évolution | Coordonner schémas de base de données, correspondances, contrats de service et éventuels systèmes de recherche exploités séparément. | Des descripteurs de types et contrats de service partagés réduisent les définitions dupliquées ; migrations et modifications d’index suivent un comportement de version explicite. |
| IA et contrôle d’accès | On ajoute généralement une passerelle d’outils et une couche de chat, puis on aligne leurs autorisations sur les chemins de données qu’elles appellent. | MCP natif et contrat de chat borné utilisent les mêmes services typés, avec l’autorisation appliquée dans les chemins de stockage et d’exécution. |
Comment le mesurer : l’avantage visé est un travail plus rapide sur les données très relationnelles, avec moins de correspondances, de synchronisation et de consommation de ressources. Mesurez la latence des requêtes, le pic de mémoire, les E/S disque, l’ingestion et l’effort de maintenance sur la même charge de travail et le même matériel. Un entrepôt de données ou une pile SQL mature peut rester mieux adapté à l’analytique tabulaire à grande échelle ou lorsque certaines extensions sont indispensables.
Une réponse d’IA devient plus utile lorsqu’elle peut relier le bon document à la bonne entité, au bon lieu et au bon moment. Cygnus doit intégrer la recherche, la logique métier appelable et les enregistrements de conversation dans le modèle du backend.
Le Model Context Protocol offre aux agents autorisés un moyen découvrable et typé d’utiliser les fonctions du backend. La découverte et l’exécution des outils respectent les autorisations de l’appelant, avec les mêmes contrats de service que les applications.
Le contrat de chat prévu, indépendant des fournisseurs, couvre les messages, les événements de streaming, les appels d’outils, les sorties structurées et des enregistrements durables de sessions et d’exécutions. Les liaisons de modèles, locales ou distantes, sont sélectionnées et qualifiées explicitement pour chaque déploiement.
Associez recherche plein texte et recherche vectorielle au contexte du graphe, spatial et historique. Conservez les références aux versions des sources et au contexte temporel choisi, pour qu’une personne puisse examiner les éléments probants et comprendre comment une réponse a été construite.
Les règles d’accès aux données s’appliquent avant toute divulgation et tout classement de recherche. Le contenu récupéré et les sorties du modèle ne donnent aucune autorisation d’agir ; les actions protégées exigent leur propre habilitation et, lorsque c’est prévu, une décision humaine.
« Quelles cargaisons se trouvaient hier à bord de navires dans la zone de tempête, et quels rapports expliquent le risque ? »
Cette charge de travail maritime proposée réunit tous les éléments de l’architecture. La même approche peut relier équipements, télémesures et maintenance dans des applications pour l’énergie, l’industrie ou les infrastructures.
Comment la réponse est construite
Sélectionner l’intervalle d’hier et préciser si la question s’appuie sur ce qui était connu alors ou sur des éléments corrigés depuis.
Utiliser la sélection géospatiale et des plages de séries temporelles pour identifier les navires dont la trajectoire a croisé la zone de tempête.
Parcourir les relations historiques du navire avec les cargaisons, les opérateurs et les ports, en ne résolvant que les parties nécessaires du graphe.
Combiner recherche par mots-clés et recherche sémantique sur les versions de documents autorisées, rattachées aux entités et au contexte temporel sélectionnés.
Un service typé ou un outil MCP renvoie les éléments probants. Le chat peut les expliquer tout en conservant les sources et le contexte pertinent.
Nous séparons ce qui est prouvé de ce qui arrive, et signalons les deux. NatusAI Cygnus est prévu pour une première version (v1).
Cygnus héberge les données et la logique métier. NatusAI Lyra les affiche, NatusAI Auriga et Aquila permettent à l’IA de les exploiter, NatusAI Orion construit des applications dessus, NatusAI Draco les exploite et NatusAI Gemini les restaure.
Ce qu’est Cygnus. Une base de données de graphe temporel programmable, prévue avec son propre langage typé, un modèle de requête optimisé et un runtime backend. Graphe, géospatial, vectoriel, sémantique de triplets (triple-store), séries temporelles et recherche plein texte partagent un seul modèle, avec une identité, un modèle transactionnel et une frontière d’autorisation uniques.
| Profil | Première version | Limite |
|---|---|---|
| Embarqué | Inclus | Un seul processus applicatif avec stockage local. |
| Développement | Inclus | Initialisation de projet vierge et modes de source explicites. |
| Production, serveur unique | Inclus | Un nœud ; sauvegarde, restauration à un instant donné et restauration vérifiée dans le périmètre. |
| Cluster | Exclu | Aucune revendication de sharding, de réplication, de parcours distribué ou de basculement. |
| Charge de travail isolée | Exclu | Pas de profil de charge de travail isolée qualifié séparément. |
| Critère | Seuil proposé | Statut |
|---|---|---|
| Partenaires de conception en production sur la charge de référence | Au moins 3 | Pas encore atteint |
| Système de référence en production avec historique conservé | Au moins 1, avec au moins 6 mois d’historique | Pas encore atteint |
| Ingestion soutenue de positions, classe de référence 32 vCPU | ≥ 100 000 rapports/s | Pas encore atteint |
| Navires dans un polygone parmi 250 000 positions en direct | p99 ≤ 150 ms | Pas encore atteint |
| Recherche hybride top-20 sur 5 millions de documents | p99 ≤ 300 ms | Pas encore atteint |
| Exactitude hors mémoire | Jeu de données ≥ 24 × RAM | Pas encore atteint |
| Surcoût de l’autorisation au niveau de l’élément | ≤ 2 × politique à granularité grossière | Pas encore atteint |
| Commits confirmés perdus sur un serveur | Zéro | Pas encore atteint |
| Tests de restauration vérifiée planifiés | 100 % de réussite | Pas encore atteint |
| Évaluations de projets vierges pilotées par des agents, sans réparation humaine | ≥ 70 % de réussite | Pas encore atteint |
Fonctionne sur vos serveurs comme un seul système, sans services distincts de recherche, de graphe et de séries temporelles dont il faudrait acquérir les licences et assurer la sécurité.
Les réponses conservent les références à la version de la source et au moment qu’elles ont utilisés.
Les règles d’accès aux données s’appliquent avant tout affichage ou classement. Un texte récupéré ne donne jamais à une IA l’autorisation d’agir.
La restauration vérifiée et la restauration à un instant donné sont des exigences de mise en production, pas des options.
Les enjeux, les approches et les résultats utiles tirés de nos récits sectoriels et de nos architectures de référence. Chaque exemple met en avant les dimensions qui rendent le problème adapté au modèle unifié prévu de Cygnus.
01 · Banque et services financiers
Comptes → Transactions → Investigation
Adéquation CygnusGrapheTripletsHistorique temporelPlein texte
02 · Énergie et réseaux
Actifs du réseau → Relevés de compteurs → Maintenance
Adéquation CygnusGrapheGéospatialSéries temporellesHistorique temporel
03 · Industrie
Équipement → Historique des capteurs → Intervention
Adéquation CygnusGrapheSéries temporellesHistorique temporel
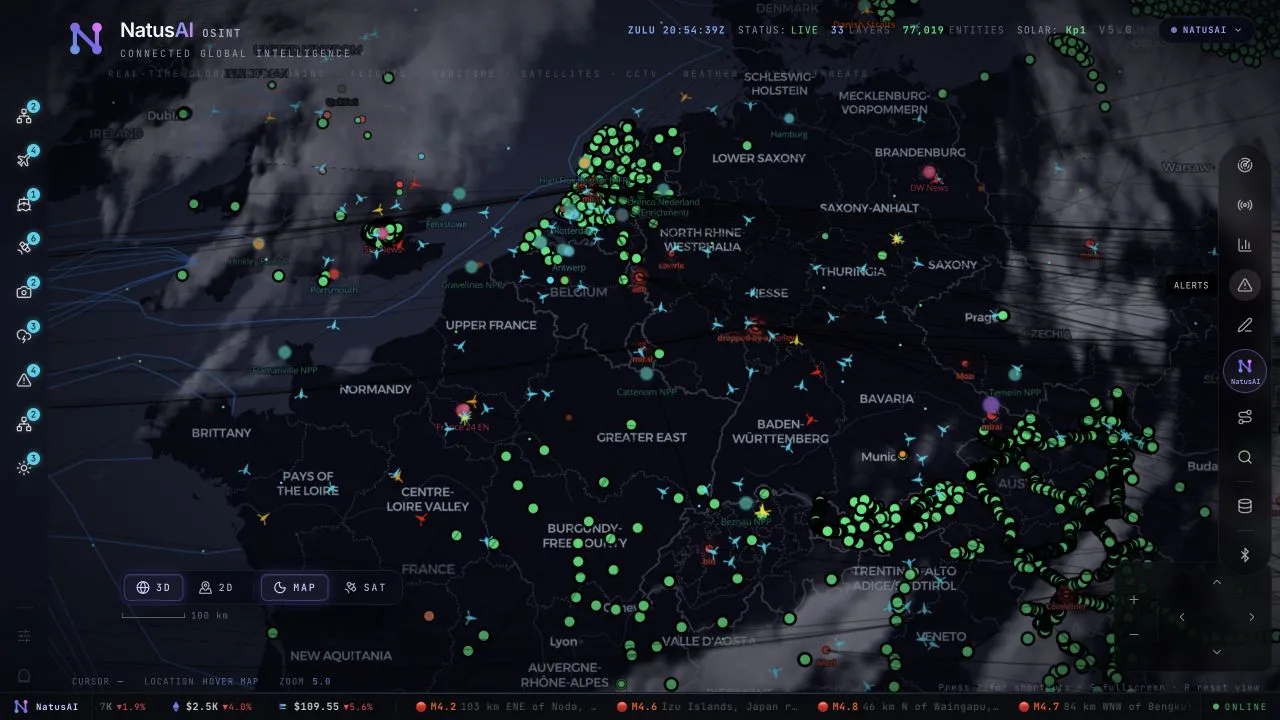
04 · OSINT
Lieux et événements → Rapports sources → Évaluation
Adéquation CygnusGéospatialGraphePlein texteHistorique temporel
05 · Solaire et planification des infrastructures
Bâtiments → Conditions d’ensoleillement → Scénarios
Adéquation CygnusGéospatialGrapheSéries temporelles
06 · Télécommunications
Client → Demande de service → Relais vers un humain
Adéquation CygnusGraphePlein texteHistorique temporelChat
07 · Commerce et chaînes d’approvisionnement
Flux commerciaux → Dépendances → Perturbation
Adéquation CygnusGrapheGéospatialHistorique temporelChat
Ces récits décrivent des projets, des processus explorés et des architectures de référence. Les étiquettes « Adéquation Cygnus » les rattachent au produit prévu ; elles n’attestent pas d’un déploiement de Cygnus publié.

Un socle complémentaire
NatusAI Lyra fournit des composants web réutilisables pour les cartes, les graphes, la recherche et les processus applicatifs. L’intégration plus large avec Orion et Cygnus relève de la vision de la plateforme. Découvrir NatusAI Lyra
Des composants d’interface réutilisables pour les tableaux de bord, les cartes, les documents et les conversations avec l’IA.
Transformez vos documents en connaissances citables, la source à portée de clic.
Des assistants IA et des outils qui agissent dans les limites d’autorisations et de budgets fixées par vos équipes.
Des réponses courtes pour les décideurs. Votre équipe technique trouvera le détail dans la section dépliable ci-dessus.
Pas encore. Cygnus est prévu pour une première version qui ne sera acceptée qu’après réussite des tests d’acceptation définis. Le moteur de nos projets clients a déjà fait ses preuves en production, et notre équipe construit dessus dès aujourd’hui.
Non. La première version cible un serveur unique. Un modèle de données mondial peut fonctionner sur un seul nœud, dans les limites testées ; une couverture géographique mondiale n’implique pas un cluster.
Pas nécessairement. Cygnus est conçu pour les travaux connectés, riches en relations. Pour un reporting tabulaire volumineux, un entrepôt de données ou une pile SQL mature peut rester plus adapté, et Cygnus peut fonctionner à côté.
Venez avec l’une d’elles. Nous vous montrerons comment un modèle connecté y répondrait, et ce que cela impliquerait.
Ou écrivez-nous à contact@natusai.com