NatusAI
Vztahy
Zákazníci, zařízení, smlouvy a události propojené přímo, takže vlastnictví, závislosti i příčiny lze snadno sledovat.
 Propojený datový základ · Vrstva 01 · Propojený základPlánováno: v1
Cygnus je plánovaný datový základ platformy NatusAI. Drží pohromadě aktiva, dokumenty, místa, měření a vztahy mezi nimi, takže lidé i schválení AI asistenti budou moci odpovídat na otázky, které dřív trvaly dny.
Plánovaný rozsah v1 a 25 akceptačních bran →Roadmapa: další profily →
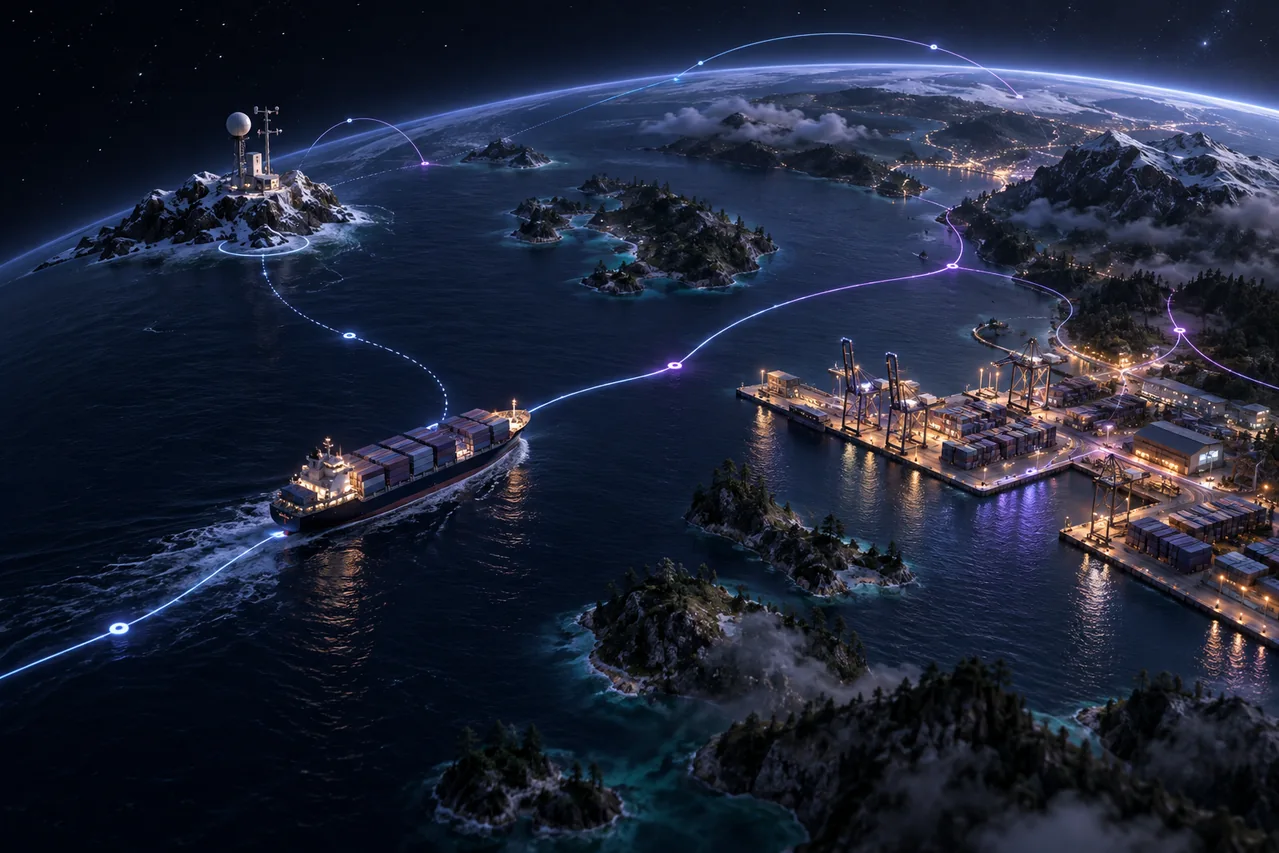
Údaj ze senzoru má čas, místo, aktivum a zdroj. Smlouva odkazuje na stejné aktivum. Cygnus tato propojení uchovává, takže odpovědi po nich vedou, místo aby je pokaždé skládaly znovu.
Zákazníci, zařízení, smlouvy a události propojené přímo, takže vlastnictví, závislosti i příčiny lze snadno sledovat.
Kdo co provozuje, která zpráva popisuje který incident: fakta navázaná na věci, které popisují.
Pozice, trasy a oblasti propojené s aktivy, ke kterým patří, i s jejich historií.
Naměřené hodnoty uložené u aktiv, která popisují – od jednoho okamžiku po roky historie.
Najděte informace podle toho, co říkají, a pak je dohledejte zpět k původnímu zdroji.
Názvy, identifikátory a pasáže v kombinaci se vztahy, místem a časem.


Loď vplula do oblasti bouře ve 14:00. Opravená poloha dorazila ve 14:10. Cygnus je navržený tak, aby zrekonstruoval rozhodnutí ze 14:05 s tím, co se tehdy vědělo, nebo ukázal opravený obraz. Právě takovou historii požaduje auditor nebo dozorový orgán.
Cygnus má spojit vlastní typovaný programovací jazyk s úložištěm, prováděním a službami. Obchodní logika pracuje přímo s perzistentními entitami a jejich vztahy, takže ubude převádění mezi řádky databáze, aplikačními objekty a odpověďmi API.
Stejný typovaný model nese data z trvalého úložiště do aplikační logiky i do kontraktů služeb. Méně mapování znamená méně míst, kde se mohou rozejít typy, názvy polí a definice vztahů.
Začnete v indexovaném vstupním bodě, projdete vztahy, které potřebujete, a výsledek omezíte časem, prostorem nebo vyhledáváním. Optimalizovaný dotazovací model se snaží tuto práci odvést blízko úložišti a vrátit jen požadovaný výsledek.
Typované funkce se stávají aplikačními službami a schválenými nástroji. HTTP/RPC, streaming, generovaní klienti v TypeScriptu a deskriptory MCP jsou součástí návrhu backendu, takže ubude samostatných adaptérových vrstev, které je třeba udržovat.
Velký graf není nutné načíst do paměti celý. Perzistentní reference umožňují operaci načíst relevantní uzly, stránky indexů a časové rozsahy až ve chvíli, kdy je potřebuje.
Pohled na jednu loď by neměl vyžadovat načtení všech lodí, všech dokumentů a celé historie poloh. Selektivní průchod a ohraničená čtení mají udržet spotřebu paměti v poměru k práci, která se skutečně provádí.
Právě tudy vede cesta k rychlejším propojeným dotazům a nižší režii zdrojů: méně materializace, méně přenosů mezi službami a méně duplikovaného kontextu. Skutečné zisky závisejí na grafu, indexech, zátěži a hardwaru.
Ilustrativní přístupová cesta
01 / Trvalý graf
Loď · Náklad · Trasa · ostatní lodě · ostatní náklad · starší rozsahy zůstávají na disku.
Zpočátku se pracuje jen s referencemi a indexovaným výběrem.
02 / Relevantní pracovní sada
Vybraná loď → náklad → požadovaná trasa
Načtou se propojená data a časové okno, které tato operace používá.
03 / Ohraničený výsledek
Stránka · vzorek · stream
Vrátí se stránka, vzorek nebo stream. Velké exporty a přestavby používají ohraničené zpracování nebo trvalé úlohy.
Relační systémy se dobře hodí pro strukturované záznamy a reporting v SQL. Když ale propojená aplikace přidá historii, mapy, sémantické vyhledávání a AI, náklady se často přesouvají do joinů, objektového mapování a koordinace dalších služeb. Cygnus je navržený tak, aby tuto režii snížil uvnitř jednoho programovatelného jádra.
| Oblast | Tabulkové úložiště + aplikační stack | Jednotný temporální graf Cygnus (plánováno) |
|---|---|---|
| Ukládání dat | Entity se stávají řádky; vztahy využívají klíče a často spojovací tabulky. Aplikační kód mapuje řádky na objekty. | Typované entity a perzistentní vazby sdílejí jeden model napříč úložištěm, logikou a službami. |
| Propojené dotazy | Joiny skládají vztahy znovu až při dotazu. Hluboké cesty mohou zvyšovat složitost dotazů i mapování. | Indexované vstupní body a průchod grafem sledují uložené vztahy s časovými a prostorovými omezeními. |
| Paměť a přesuny dat | Efektivní databáze už používají indexy a cache; široké joiny a zpracování na straně aplikace přesto mohou vytvářet velké mezivýsledky. | Data grafu se načítají na vyžádání; místo materializace celé propojené datové sady se používají ohraničené rozsahy, stránky a streamy. |
| Historie a opravy | Tabulky historie, temporální rozšíření nebo modely událostí je třeba navrhnout a sladit s aplikačními dotazy. | Časový stav a bitemporální přístup jsou součástí modelu a zachovávají rozdíl mezi valid time a knowledge time. |
| Geodata, text a vektory | Rozšíření mohou přidat schopnosti do jedné databáze; specializované služby mohou potřebovat vlastní identity, indexování a synchronizaci. | Prostorová data, časové řady, text a vektory se napojují na tytéž entity a verzované zdroje. |
| Dotazovací a aplikační jazyky | SQL plus aplikační kód, mapovací knihovny a někdy samostatné dotazovací jazyky pro vyhledávání nebo grafy. | Jeden nativní typovaný jazyk a optimalizovaný dotazovací model přibližují výpočty k perzistentním strukturám grafu. |
| Údržba a vývoj | Je třeba koordinovat databázová schémata, mapování, kontrakty služeb a případná samostatně provozovaná úložiště pro vyhledávání. | Sdílené deskriptory typů a kontrakty služeb omezují duplicitní definice; migrace a změny indexů se řídí explicitním chováním verzí. |
| AI a řízení přístupu | Obvykle se přidává brána pro nástroje a chatová vrstva a jejich oprávnění se pak slaďují s datovými cestami, které volají. | Nativní MCP a ohraničený chatový kontrakt používají tytéž typované služby, s autorizací v cestách úložiště i provádění. |
Jak to měřit: zamýšlenou výhodou je rychlejší práce s množstvím vztahů a menší režie mapování, synchronizace a zdrojů. Měřte latenci dotazů, špičkovou spotřebu paměti, diskové I/O, příjem dat a náročnost údržby na stejné zátěži a stejném hardwaru. Pro rozsáhlou tabulkovou analytiku nebo tam, kde jsou nutná specifická rozšíření, může zůstat vhodnější datový sklad nebo vyzrálý SQL stack.
Odpověď AI je užitečnější, když dokáže propojit správný dokument se správnou entitou, místem a okamžikem. Cygnus má přenést vyhledávání, volatelnou obchodní logiku i záznamy konverzací do modelu backendu.
Model Context Protocol dává schváleným agentům dohledatelný, typovaný způsob, jak používat funkce backendu. Vyhledání i spuštění nástrojů se řídí oprávněními volajícího a používá stejné kontrakty služeb jako aplikace.
Plánovaný chatový kontrakt nezávislý na poskytovateli pokrývá zprávy, streamované události, volání nástrojů, strukturovaný výstup a trvalé záznamy relací a běhů. Lokální nebo vzdálené vazby na modely se pro každé nasazení výslovně vybírají a kvalifikují.
Kombinujte fulltextové a vektorové vyhledávání s grafovým, prostorovým a historickým kontextem. Odkazy na verze zdrojů a zvolený časový kontext zůstávají zachované, takže si člověk může doklady prohlédnout a pochopit, jak odpověď vznikla.
Pravidla přístupu k datům platí dřív, než se cokoli zpřístupní nebo seřadí ve výsledcích vyhledávání. Vyhledaný obsah ani výstup modelu nedávají oprávnění jednat; chráněné akce vyžadují vlastní oprávnění a tam, kde je to stanoveno, rozhodnutí člověka.
„Jaký náklad byl včera na lodích v oblasti bouře a které zprávy vysvětlují riziko?“
Tato navrhovaná námořní zátěž spojuje celou architekturu dohromady. Stejný přístup může propojit zařízení, telemetrii a údržbu v aplikacích pro energetiku, výrobu nebo infrastrukturu.
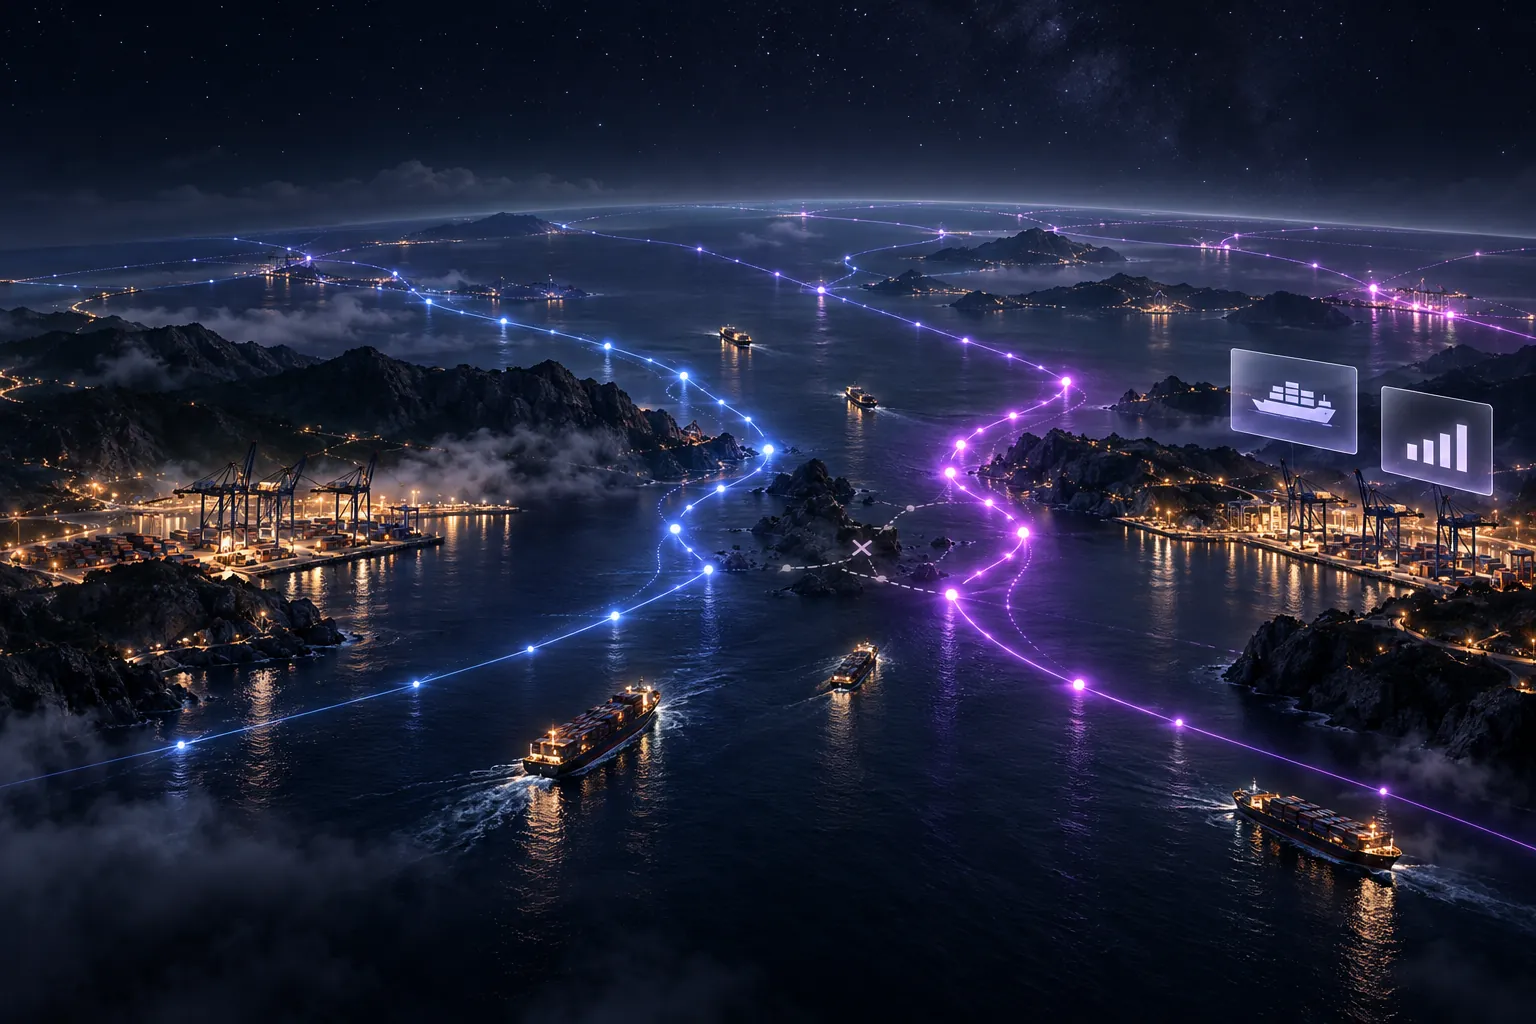
Jak odpověď vzniká
Zvolte včerejší interval a určete, zda otázka vychází z toho, co se vědělo tehdy, nebo z později opravených dokladů.
Geoprostorový výběr a rozsahy časových řad určí lodě, jejichž trasy protnuly oblast bouře.
Průchod historickými vztahy lodi k nákladu, provozovatelům a přístavům, při kterém se načítají jen potřebné části grafu.
Kombinace klíčového a sémantického vyhledávání nad schválenými verzemi dokumentů, propojenými s vybranými entitami a časovým kontextem.
Typovaná služba nebo nástroj MCP vrátí doklady. Chat je může vysvětlit a přitom zachová zdroje i relevantní kontext.
Oddělujeme to, co je prověřené, od toho, co teprve přijde, a obojí označujeme. Pro NatusAI Cygnus se plánuje první vydání (v1).
Cygnus drží data a obchodní logiku. NatusAI Lyra je zobrazuje, NatusAI Auriga a Aquila umožňují AI s nimi pracovat, NatusAI Orion nad nimi staví aplikace, NatusAI Draco je provozuje a NatusAI Gemini je obnovuje.
Co je Cygnus. Plánovaná programovatelná temporální grafová databáze: vlastní typovaný jazyk, optimalizovaný dotazovací model a backendový runtime. Graf, geoprostorová data, vektory, sémantika triple-store, časové řady a fulltextové vyhledávání sdílejí jeden model s jednou identitou, jedním transakčním modelem a jednou hranicí autorizace.
| Profil | První vydání | Hranice |
|---|---|---|
| Embedded | Zahrnuto | Jeden aplikační proces s lokálním úložištěm. |
| Vývojový | Zahrnuto | Inicializace prázdného projektu a explicitní režimy zdrojů. |
| Produkční, jeden server | Zahrnuto | Jeden uzel; zálohování, obnova k určitému okamžiku a ověřená obnova jsou v rozsahu. |
| Cluster | Nezahrnuto | Žádný sharding, replikace, distribuovaný průchod ani failover. |
| Izolovaná zátěž | Nezahrnuto | Žádný samostatně kvalifikovaný profil pro izolovanou zátěž. |
| Brána | Navrhovaná hranice | Stav |
|---|---|---|
| Produkční design partneři na referenční zátěži | Alespoň 3 | Zatím nesplněno |
| Produkční systém záznamu s uchovávanou historií | Alespoň 1, s historií 6+ měsíců | Zatím nesplněno |
| Trvalý příjem poloh, referenční třída 32 vCPU | ≥ 100 000 zpráv/s | Zatím nesplněno |
| Lodě uvnitř polygonu nad 250 000 živých poloh | p99 ≤ 150 ms | Zatím nesplněno |
| Hybridní vyhledání top-20 nad 5 miliony dokumentů | p99 ≤ 300 ms | Zatím nesplněno |
| Správnost out-of-core | Datová sada ≥ 24 × RAM | Zatím nesplněno |
| Režie autorizace na úrovni prvků | ≤ 2 × hrubozrnná politika | Zatím nesplněno |
| Potvrzené commity ztracené na jednom serveru | Nula | Zatím nesplněno |
| Plánované testy ověřené obnovy | 100 % úspěšných | Zatím nesplněno |
| Hodnocení prázdného projektu řízená agentem bez lidské opravy | ≥ 70 % úspěšných | Zatím nesplněno |
Běží na vašich serverech jako jeden systém, bez samostatných služeb pro vyhledávání, grafy a časové řady, které je třeba licencovat a zabezpečit.
Odpovědi si uchovávají odkazy na verzi zdroje a okamžik, ze kterého vycházely.
Pravidla přístupu k datům platí dřív, než se cokoli zobrazí nebo seřadí. Vyhledaný text nikdy nedává AI oprávnění jednat.
Ověřená obnova a obnova k určitému okamžiku jsou podmínkou vydání, ne volitelnou možností.
Problémy, přístupy a užitečné výsledky z našich oborových příběhů a referenčních architektur. Každý příklad ukazuje dimenze, díky kterým se problém hodí pro plánovaný jednotný model Cygnus.
01 · Bankovnictví a finanční služby
Účty → Transakce → Vyšetřování
Vhodnost pro CygnusGrafTriplyČasová historieFulltext
02 · Energetika a utility
Prvky sítě → Odečty měřidel → Údržba
Vhodnost pro CygnusGrafGeoprostorová dataČasové řadyČasová historie
03 · Výroba
Zařízení → Historie senzorů → Zásah
Vhodnost pro CygnusGrafČasové řadyČasová historie
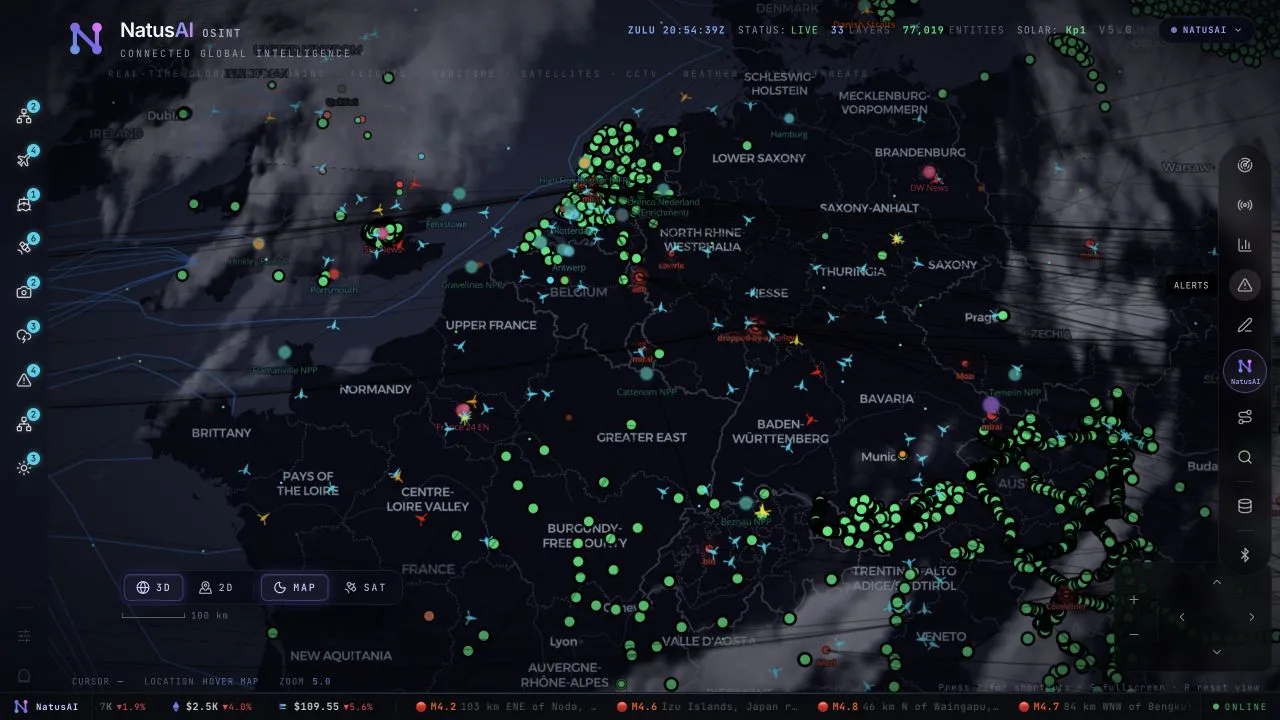
04 · OSINT
Místa a události → Zprávy ze zdrojů → Vyhodnocení
Vhodnost pro CygnusGeoprostorová dataGrafFulltextČasová historie
05 · Plánování solárních zdrojů a infrastruktury
Budovy → Solární podmínky → Scénáře
Vhodnost pro CygnusGeoprostorová dataGrafČasové řady
06 · Telekomunikace
Zákazník → Servisní požadavek → Předání člověku
Vhodnost pro CygnusGrafFulltextČasová historieChat
07 · Obchod a dodavatelské řetězce
Obchodní toky → Závislosti → Narušení
Vhodnost pro CygnusGrafGeoprostorová dataČasová historieChat
Tyto příběhy popisují projekty, prozkoumané pracovní postupy a referenční architektury. Štítky vhodnosti pro Cygnus je přiřazují k plánovanému produktu; nedokládají vydané nasazení Cygnus.

Párový základ
NatusAI Lyra nabízí opakovaně použitelné webové komponenty pro mapy, grafy, vyhledávání a aplikační pracovní postupy. Širší integrace s Orion a Cygnus je součástí vize platformy. Více o NatusAI Lyra
Opakovaně použitelné komponenty rozhraní pro dashboardy, mapy, dokumenty a konverzace s AI.
Z dokumentů se stanou znalosti, které můžete citovat – se zdrojem na jedno kliknutí.
AI asistenti a nástroje, které pracují v mezích oprávnění a rozpočtů stanovených vašimi lidmi.
Stručné odpovědi pro vedení. Podrobnosti najde váš technický tým v rozbalovací části výše.
Zatím ne. Pro Cygnus se plánuje první vydání, které bude přijato teprve poté, co projde stanovenými akceptačními testy. Stejné jádro jako v našich klientských projektech je už prověřené v praxi a náš tým na něm staví už dnes.
Ne. První vydání cílí na jeden server. Celosvětový datový model může v rámci otestovaných limitů běžet na jednom uzlu; globální geografie neznamená nutnost clusteru.
Ne nutně. Cygnus je navržený pro propojenou práci s množstvím vztahů. Pro rozsáhlý tabulkový reporting může zůstat vhodnější datový sklad nebo vyzrálý SQL stack a Cygnus může běžet vedle něj.
Přineste jednu. Ukážeme vám, jak by na ni odpověděl propojený model a co by to obnášelo.
Nebo nám napište na contact@natusai.com