NatusAI
Relationer
Kunder, utrustning, avtal och händelser kopplas direkt till varandra, så att ägarskap, beroenden och orsaker är lätta att följa.
 Sammankopplad datagrund · Lager 01 · Sammankopplad grundPlanerad v1
Cygnus är den planerade datagrunden i NatusAI-plattformen. Den håller ihop tillgångar, dokument, platser, mätvärden och deras relationer, så att människor och godkända AI-assistenter kan besvara frågor som tidigare tog dagar.
Planerad omfattning för v1 och 25 acceptanskrav →Färdplan: senare profiler →
Ett sensorvärde har en tidpunkt, en plats, en tillgång och en källa. Ett avtal hänvisar till samma tillgång. Cygnus behåller de här kopplingarna, så att svaren följer dem i stället för att bygga upp dem på nytt varje gång.
Kunder, utrustning, avtal och händelser kopplas direkt till varandra, så att ägarskap, beroenden och orsaker är lätta att följa.
Vem som driver vad, vilken rapport som beskriver vilken incident: fakta knutna till det de beskriver.
Positioner, spår och områden kopplade till de tillgångar de hör till, och till deras historik.
Mätvärden lagras bredvid de tillgångar de beskriver, från ett enskilt ögonblick till flera års historik.
Hitta information utifrån vad den säger och följ den sedan tillbaka till originalkällan.
Namn, identifierare och textavsnitt, kombinerat med relationer, plats och tid.


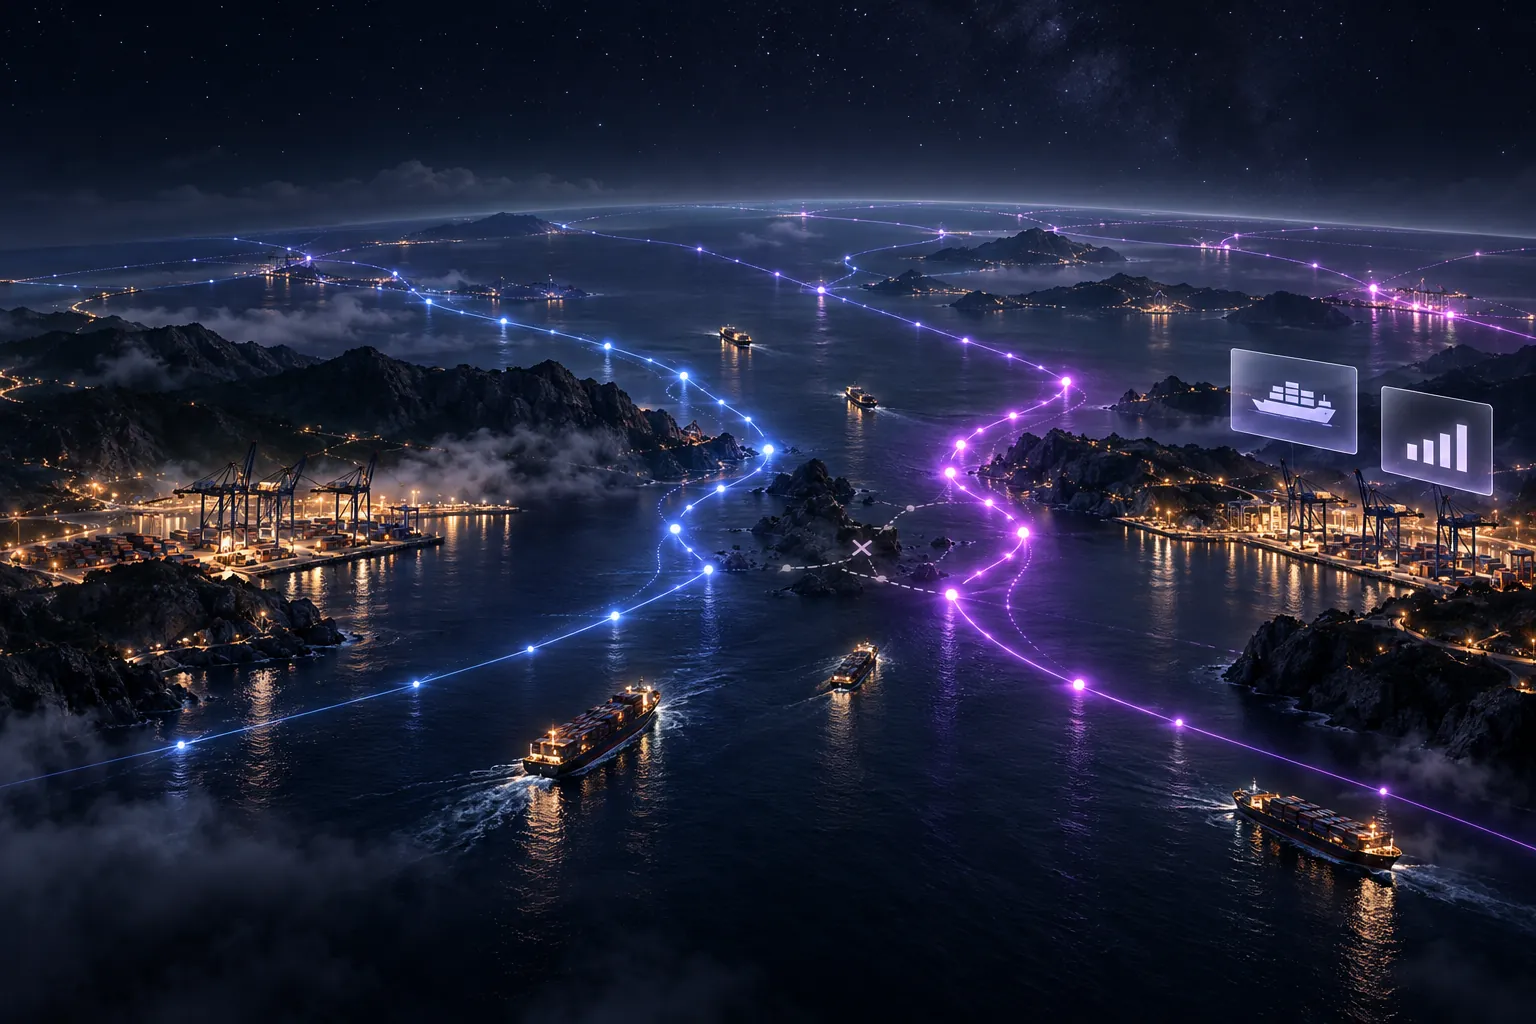
Ett fartyg gick in i ett stormområde kl. 14.00. En korrigerad position kom kl. 14.10. Cygnus är utformad för att rekonstruera beslutet kl. 14.05 med det som var känt vid tidpunkten, eller visa den korrigerade bilden. Det är den historik som en revisor eller tillsynsmyndighet efterfrågar.
Cygnus är planerad att kombinera ett eget typat programmeringsspråk med lagring, exekvering och tjänster. Affärslogiken arbetar direkt med beständiga entiteter och deras relationer, vilket minskar översättningen mellan databasrader, applikationsobjekt och API-svar.
Samma typade modell bär data från beständig lagring in i applikationslogiken och tjänstekontrakten. Färre mappningar betyder färre ställen där typer, fältnamn och relationsdefinitioner kan glida isär.
Börja i en indexerad ingångspunkt, följ de relationer du behöver och avgränsa efter tid, plats eller sökning. Den optimerade frågemodellen är avsedd att göra det arbetet nära lagringen och bara returnera det efterfrågade resultatet.
Typade funktioner blir applikationstjänster och godkända verktyg. HTTP/RPC, strömning, genererade TypeScript-klienter och MCP-deskriptorer ingår i backend-designen, vilket minskar antalet separata adapterlager att underhålla.
En stor graf behöver inte läsas in helt i minnet. Beständiga referenser låter en operation läsa in relevanta noder, indexsidor och tidsintervall när de behövs.
Att titta på ett fartyg ska inte kräva att alla fartyg, alla dokument och hela positionshistoriken läses in. Selektiv traversering och avgränsade läsningar är utformade för att minnesanvändningen ska följa det arbete som faktiskt utförs.
Det är vägen till snabbare sammankopplade frågor och lägre resursåtgång: mindre materialisering, färre överföringar mellan tjänster och mindre duplicerat sammanhang. Den faktiska vinsten beror på graf, index, arbetslast och hårdvara.
Illustrativ åtkomstväg
01 / Beständig graf
Fartyg · Last · Rutt · andra fartyg · annan last · äldre intervall ligger kvar på disk.
Först berörs bara referenser och ett indexerat urval.
02 / Relevant arbetsmängd
Valt fartyg → last → efterfrågat spår
Läs in de sammankopplade data och det tidsfönster som operationen använder.
03 / Avgränsat resultat
Sida · urval · ström
Returnera en sida, ett urval eller en ström. Stora exporter och ombyggnader använder avgränsad bearbetning eller beständiga jobb.
Relationsdatabaser fungerar bra för strukturerade poster och SQL-rapportering. När en sammankopplad applikation lägger till historik, kartor, semantisk hämtning och AI flyttas kostnaden ofta mot joins, objektmappning och samordning av extra tjänster. Cygnus är utformad för att minska den overheaden i en enda programmerbar motor.
| Dimension | Tabellagring + applikationsstack | Cygnus samlade temporala graf (planerad) |
|---|---|---|
| Datalagring | Entiteter blir rader; relationer använder nycklar och ofta kopplingstabeller. Applikationskoden mappar rader till objekt. | Typade entiteter och beständiga länkar delar en modell i lagring, logik och tjänster. |
| Sammankopplade frågor | Joins återskapar relationer när frågan körs. Djupa vägar kan göra frågor och mappning mer komplexa. | Indexerade ingångspunkter och grafnavigering följer lagrade relationer, med tidsmässiga och rumsliga villkor. |
| Minne och dataförflyttning | Effektiva motorer använder redan index och cacher; breda joins och bearbetning på applikationssidan kan ändå skapa stora mellanresultat. | Läs in grafdata vid behov; använd avgränsade intervall, sidor och strömmar i stället för att materialisera hela den sammankopplade datamängden. |
| Historik och korrigeringar | Historiktabeller, temporala tillägg eller händelsemodeller måste utformas och anpassas till applikationens frågor. | Tidsmässigt tillstånd och bitemporal åtkomst ingår i modellen, och skillnaden mellan giltighetstid och kunskapstid bevaras. |
| Geodata, text och vektorer | Tillägg kan ge nya förmågor i en databas; specialiserade tjänster kan behöva egna vägar för identitet, indexering och synkronisering. | Rumsliga data, tidsserier, text och vektorer kopplas till samma entiteter och versionerade källor. |
| Fråge- och applikationsspråk | SQL plus applikationskod, mappningsbibliotek och ibland separata frågespråk för sökning eller graf. | Ett inbyggt typat språk och en optimerad frågemodell flyttar beräkningarna nära de beständiga grafstrukturerna. |
| Underhåll och vidareutveckling | Databasscheman, mappningar, tjänstekontrakt och eventuella separat drivna söklager måste samordnas. | Gemensamma typdeskriptorer och tjänstekontrakt minskar dubblerade definitioner; migreringar och indexändringar följer ett uttryckligt versionsbeteende. |
| AI och åtkomstkontroll | Oftast läggs en verktygsgateway och ett chattlager till, vars behörigheter sedan måste anpassas till de datavägar de anropar. | Inbyggd MCP och ett avgränsat chattkontrakt använder samma typade tjänster, med behörighetskontroll i lagrings- och exekveringsvägarna. |
Så mäter du det: den avsedda fördelen är snabbare relationstungt arbete med mindre mappning, synkronisering och resursåtgång. Mät frågelatens, maximal minnesanvändning, disk-I/O, inläsning och underhållsinsats på samma arbetslast och hårdvara. Ett datalager eller en mogen SQL-stack kan fortfarande passa bättre för stora tabellanalyser eller när vissa tillägg krävs.
Ett AI-svar blir mer användbart när det kan koppla rätt dokument till rätt entitet, plats och tidpunkt. Cygnus är planerad att föra in hämtning, anropbar affärslogik och konversationsposter i backend-modellen.
Model Context Protocol ger godkända agenter ett upptäckbart, typat sätt att använda backend-funktioner. Upptäckt och körning av verktyg följer anroparens behörigheter, med samma tjänstekontrakt som applikationerna använder.
Det planerade leverantörsneutrala chattkontraktet omfattar meddelanden, strömmade händelser, verktygsanrop, strukturerad utdata och beständiga poster för sessioner och körningar. Lokala eller externa modellbindningar väljs och kvalificeras uttryckligen för driftsättningen.
Kombinera fulltext- och vektorhämtning med sammanhang från graf, plats och historik. Behåll referenser till källversioner och den valda tidskontexten, så att en människa kan granska beläggen och förstå hur ett svar kom till.
Regler för dataåtkomst tillämpas före visning och sökrankning. Hämtat innehåll och modellens utdata ger ingen behörighet att agera; skyddade åtgärder kräver egen behörighet och, där det anges, ett mänskligt beslut.
”Vilken last fanns på fartyg inom stormområdet i går, och vilka rapporter förklarar risken?”
Den här föreslagna sjöfartsarbetslasten knyter ihop arkitekturen. Samma angreppssätt kan koppla ihop utrustning, telemetri och underhåll i applikationer för energi, tillverkning eller infrastruktur.
Så byggs svaret upp
Välj gårdagens intervall och om frågan ska använda det som var känt då eller senare korrigerade belägg.
Använd geospatialt urval och tidsserieintervall för att identifiera fartyg vars spår korsade stormområdet.
Traversera fartygets historiska relationer till last, operatörer och hamnar, och läs bara in de delar av grafen som behövs.
Kombinera nyckelords- och semantisk sökning i godkända dokumentversioner, kopplade till de valda entiteterna och tidskontexten.
En typad tjänst eller ett MCP-verktyg returnerar beläggen. Chatten kan förklara dem och samtidigt behålla källorna och det relevanta sammanhanget.
Vi skiljer på det som är bevisat och det som är på väg, och märker båda. NatusAI Cygnus är planerad för sin första version (v1).
Cygnus håller data och affärslogik. NatusAI Lyra visar dem, NatusAI Auriga och Aquila låter AI arbeta med dem, NatusAI Orion bygger applikationer på dem, NatusAI Draco driver dem och NatusAI Gemini återställer dem.
Vad Cygnus är. En planerad programmerbar temporal grafdatabas: ett eget typat språk, en optimerad frågemodell och en körmiljö för backend. Graf, geospatial data, vektorer, triple-store-semantik, tidsserier och fulltextsökning delar en modell, med en identitet, en transaktionsmodell och en behörighetsgräns.
| Profil | Första versionen | Avgränsning |
|---|---|---|
| Inbäddad | Ingår | En applikationsprocess med lokal lagring. |
| Utveckling | Ingår | Uppstart från tomt projekt och explicita källlägen. |
| Produktion, en server | Ingår | En nod; säkerhetskopiering, återställning till valfri tidpunkt och verifierad återställning ingår. |
| Kluster | Ingår inte | Inga anspråk på sharding, replikering, distribuerad traversering eller failover. |
| Isolerad arbetslast | Ingår inte | Ingen separat kvalificerad profil för isolerade arbetslaster. |
| Krav | Föreslaget tröskelvärde | Status |
|---|---|---|
| Designpartner i produktion på referensarbetslasten | Minst 3 | Ännu inte uppfyllt |
| Produktionssystem för primärdata med bevarad historik | Minst 1, med 6+ månaders historik | Ännu inte uppfyllt |
| Uthållig inläsning av positioner, referensklass 32 vCPU | ≥ 100 000 rapporter/s | Ännu inte uppfyllt |
| Fartyg inom en polygon bland 250 000 aktuella positioner | p99 ≤ 150 ms | Ännu inte uppfyllt |
| Hybrid topp 20-hämtning över 5 miljoner dokument | p99 ≤ 300 ms | Ännu inte uppfyllt |
| Korrekthet out-of-core | Datamängd ≥ 24 × RAM | Ännu inte uppfyllt |
| Merkostnad för behörighet på elementnivå | ≤ 2 × grovkornig policy | Ännu inte uppfyllt |
| Förlorade bekräftade commits på en server | Noll | Ännu inte uppfyllt |
| Schemalagda tester av verifierad återställning | 100 % godkända | Ännu inte uppfyllt |
| Agentdrivna utvärderingar från tomt projekt utan mänsklig reparation | ≥ 70 % lyckas | Ännu inte uppfyllt |
Körs på dina servrar som ett system, utan separata tjänster för sökning, graf och tidsserier att licensiera och säkra.
Svaren behåller referenser till den källversion och den tidpunkt de använde.
Regler för dataåtkomst tillämpas innan något visas eller rankas. Hämtad text ger aldrig en AI behörighet att agera.
Verifierad återställning och återställning till valfri tidpunkt är krav för release, inte tillval.
Problemen, angreppssätten och de användbara resultaten från våra branschberättelser och referensarkitekturer. Varje exempel lyfter fram de dimensioner som gör att problemet passar den planerade samlade modellen i Cygnus.
01 · Bank och finans
Konton → Transaktioner → Utredning
Passar CygnusGrafTripletterTidshistorikFulltext
02 · Energi och försörjning
Nätanläggningar → Mätaravläsningar → Underhåll
Passar CygnusGrafGeospatialtTidsserierTidshistorik
03 · Tillverkning
Utrustning → Sensorhistorik → Åtgärd
Passar CygnusGrafTidsserierTidshistorik
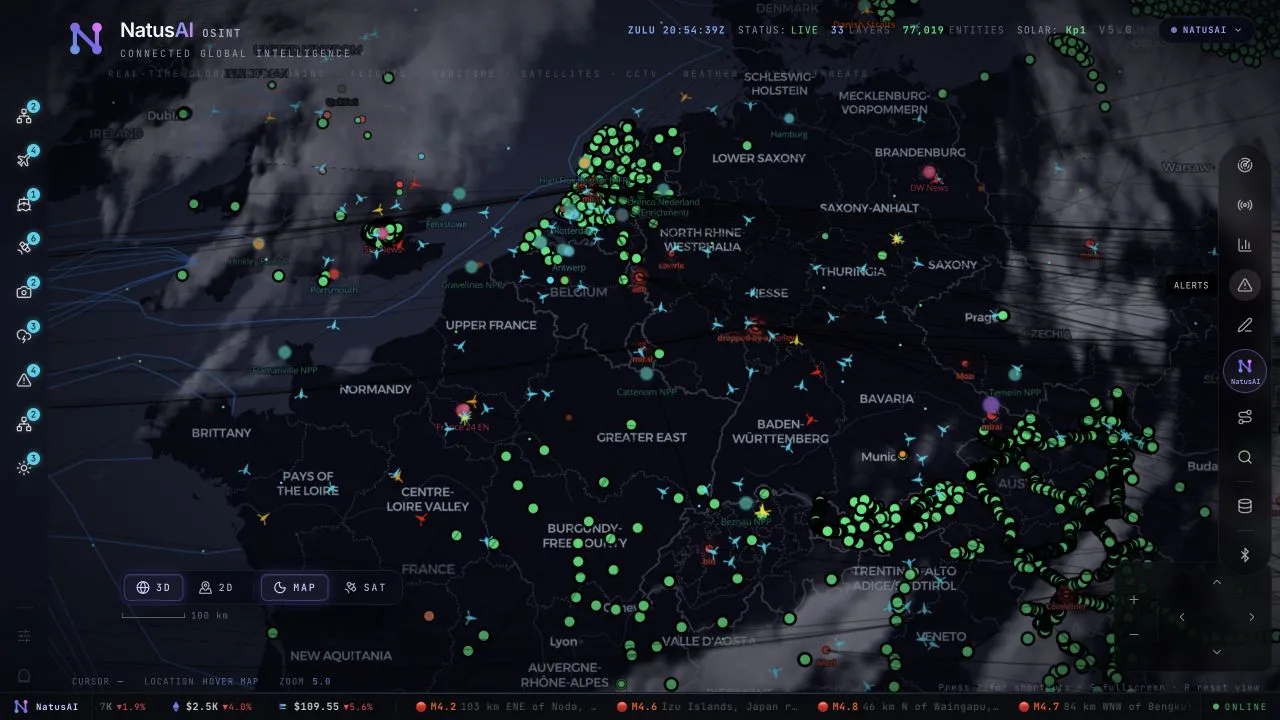
04 · OSINT
Platser och händelser → Källrapporter → Bedömning
Passar CygnusGeospatialtGrafFulltextTidshistorik
05 · Sol- och infrastrukturplanering
Byggnader → Solförhållanden → Scenarier
Passar CygnusGeospatialtGrafTidsserier
06 · Telekommunikation
Kund → Serviceärende → Överlämning till en människa
Passar CygnusGrafFulltextTidshistorikChatt
07 · Handel och leveranskedjor
Handelsflöden → Beroenden → Störning
Passar CygnusGrafGeospatialtTidshistorikChatt
Berättelserna beskriver projekt, utforskade arbetsflöden och referensarkitekturer. Etiketterna ”Passar Cygnus” kopplar dem till den planerade produkten; de visar inte att Cygnus har släppts eller driftsatts.

Två delar av samma grund
NatusAI Lyra erbjuder återanvändbara webbkomponenter för kartor, grafer, sökning och applikationsflöden. Den bredare integrationen mellan Orion och Cygnus är en del av plattformsvisionen. Utforska NatusAI Lyra
Återanvändbara gränssnittskomponenter för dashboards, kartor, dokument och AI-konversationer.
Gör dokument till kunskap du kan hänvisa till, med källan ett klick bort.
AI-assistenter och verktyg som arbetar inom de behörigheter och budgetar som dina medarbetare sätter.
Korta svar för beslutsfattare. Ditt tekniska team hittar detaljerna i den utfällbara delen ovan.
Inte än. Cygnus är planerad för en första version som godkänns först när dess fastställda acceptanstester är uppfyllda. Samma motor som i våra kundprojekt har redan bevisat sig i leveranser, och vårt team bygger på den i dag.
Nej. Den första versionen är avsedd för en server. En global datamodell kan köras på en nod inom sina testade gränser; global geografi betyder inte att det krävs ett kluster.
Inte nödvändigtvis. Cygnus är utformad för sammankopplat arbete med många relationer. För stor tabellrapportering kan ett datalager eller en mogen SQL-stack fortfarande passa bättre, och Cygnus kan finnas vid sidan om.
Ta med en. Vi visar hur en sammankopplad modell skulle besvara den, och vad som krävs.
Eller skriv till contact@natusai.com