NatusAI
Relazioni
Clienti, impianti, contratti ed eventi collegati direttamente, così proprietà, dipendenze e cause sono facili da seguire.
 Fondamenta di dati connessi · Livello 01 · Fondamenta connesseV1 prevista
Cygnus è il fondamento dati pianificato della piattaforma NatusAI. Tiene insieme asset, documenti, luoghi, misurazioni e le loro relazioni, così le persone e gli assistenti IA approvati possono rispondere a domande che prima richiedevano giorni.
Perimetro pianificato della v1 e 25 criteri di accettazione →Roadmap: i profili successivi →
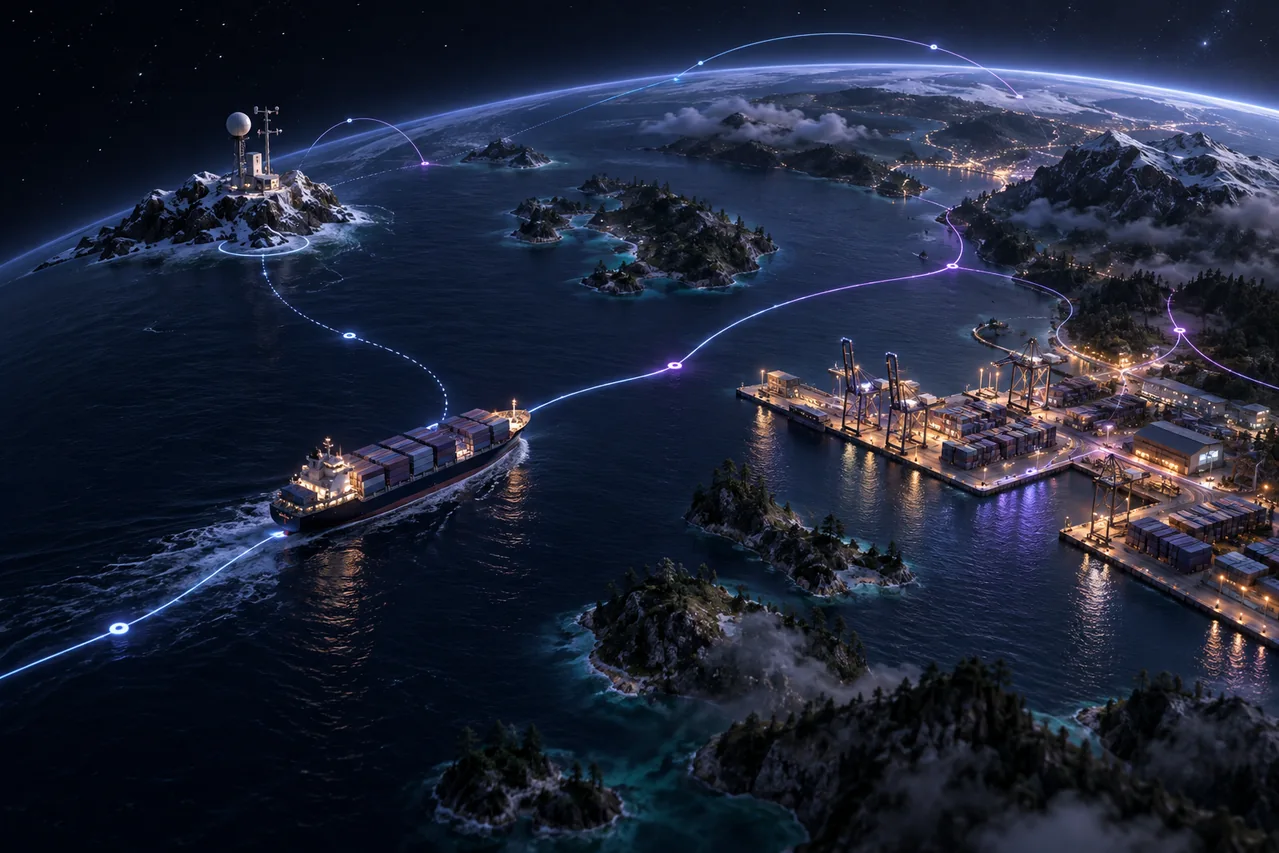
La lettura di un sensore ha un orario, un luogo, un asset e una fonte. Un contratto fa riferimento allo stesso asset. Cygnus conserva questi collegamenti, così le risposte li seguono invece di ricostruirli ogni volta.
Clienti, impianti, contratti ed eventi collegati direttamente, così proprietà, dipendenze e cause sono facili da seguire.
Chi gestisce cosa, quale rapporto descrive quale incidente: fatti legati alle cose che descrivono.
Posizioni, tracciati e aree collegati agli asset a cui appartengono e alla loro storia.
Letture conservate accanto agli asset che descrivono, da un singolo istante fino ad anni di storico.
Trovate le informazioni in base a ciò che dicono, poi risalite alla fonte originale.
Nomi, identificativi e passaggi, combinati con relazioni, luogo e tempo.


Una nave è entrata in un'area di tempesta alle 14:00. Una posizione corretta è arrivata alle 14:10. Cygnus è progettato per ricostruire la decisione delle 14:05 con ciò che si sapeva in quel momento, oppure per mostrare il quadro corretto. È lo storico che chiedono un revisore o un'autorità di vigilanza.
Secondo i piani, Cygnus unirà un proprio linguaggio di programmazione tipizzato con storage, esecuzione e servizi. La logica di business lavora direttamente con le entità persistenti e le loro relazioni, riducendo le traduzioni tra righe di database, oggetti applicativi e risposte delle API.
Lo stesso modello tipizzato porta i dati dallo storage persistente alla logica applicativa e ai contratti dei servizi. Meno mappature significano meno punti in cui tipi, nomi dei campi e definizioni delle relazioni possono divergere.
Partite da un punto di ingresso indicizzato, seguite le relazioni che vi servono e restringete per tempo, spazio o ricerca. Il modello di query ottimizzato punta a svolgere questo lavoro vicino allo storage e a restituire solo il risultato richiesto.
Le funzioni tipizzate diventano servizi applicativi e strumenti autorizzati. HTTP/RPC, streaming, client TypeScript generati e descrittori MCP fanno parte della progettazione del backend, riducendo i livelli di adattatori separati da mantenere.
Un grafo di grandi dimensioni non deve essere caricato interamente in memoria. I riferimenti persistenti permettono a un'operazione di risolvere i nodi, le pagine di indice e gli intervalli temporali pertinenti nel momento in cui servono.
Esaminare una nave non dovrebbe richiedere il caricamento di tutte le navi, di tutti i documenti e dell'intero storico delle posizioni. L'attraversamento selettivo e le letture delimitate sono progettati per legare l'uso della memoria al lavoro effettivamente svolto.
È questa la strada verso query connesse più rapide e un minore consumo di risorse: meno materializzazione, meno trasferimenti tra servizi e meno contesto duplicato. I guadagni effettivi dipendono da grafo, indici, carico di lavoro e hardware.
Percorso di accesso illustrativo
01 / Grafo persistente
Nave · Carico · Rotta · altre navi · altri carichi · gli intervalli più vecchi restano su disco.
All'inizio si toccano solo i riferimenti e una selezione indicizzata.
02 / Working set pertinente
Nave selezionata → carico → tracciato richiesto
Risolvete i dati connessi e la finestra temporale che questa operazione utilizza.
03 / Risultato delimitato
Pagina · campione · stream
Restituite una pagina, un campione o uno stream. Le esportazioni e le ricostruzioni di grandi dimensioni usano un'elaborazione delimitata o job persistenti.
I sistemi relazionali funzionano bene per i record strutturati e la reportistica SQL. Quando un'applicazione connessa aggiunge storico, mappe, recupero semantico e IA, il costo si sposta spesso verso join, mappatura degli oggetti e coordinamento di servizi aggiuntivi. Cygnus è progettato per ridurre questo overhead all'interno di un unico motore programmabile.
| Dimensione | Storage tabellare + stack applicativo | Grafo temporale unificato Cygnus (pianificato) |
|---|---|---|
| Archiviazione dei dati | Le entità diventano righe; le relazioni usano chiavi e spesso tabelle di collegamento. Il codice applicativo mappa le righe in oggetti. | Entità tipizzate e collegamenti persistenti condividono un unico modello tra storage, logica e servizi. |
| Query connesse | I join ricostruiscono le relazioni al momento della query. I percorsi profondi possono aggiungere complessità di query e di mappatura. | Punti di ingresso indicizzati e attraversamento del grafo seguono le relazioni memorizzate, con vincoli temporali e spaziali. |
| Memoria e spostamento dei dati | I motori efficienti usano già indici e cache; join ampi ed elaborazione lato applicazione possono comunque generare grandi risultati intermedi. | Risolvere i dati del grafo su richiesta; usare intervalli, pagine e stream delimitati anziché materializzare l'intero dataset connesso. |
| Storico e correzioni | Tabelle di storico, estensioni temporali o modelli a eventi vanno progettati e allineati alle query dell'applicazione. | Stato temporale e accesso bitemporale fanno parte del modello, preservando la distinzione tra tempo di validità e tempo di conoscenza. |
| Geo, testo e vettori | Le estensioni possono aggiungere capacità in un unico database; i servizi specialistici possono richiedere propri percorsi di identità, indicizzazione e sincronizzazione. | Risorse spaziali, di serie temporali, testuali e vettoriali si collegano alle stesse entità e alle stesse fonti versionate. |
| Linguaggi di query e applicativi | SQL più codice applicativo, librerie di mappatura e talvolta linguaggi di query separati per la ricerca o il grafo. | Un unico linguaggio nativo tipizzato e un modello di query ottimizzato portano il calcolo vicino alle strutture persistenti del grafo. |
| Manutenzione ed evoluzione | Coordinare schemi di database, mappature, contratti dei servizi ed eventuali archivi di recupero gestiti separatamente. | Descrittori di tipo e contratti dei servizi condivisi riducono le definizioni duplicate; migrazioni e modifiche agli indici seguono un comportamento di versione esplicito. |
| IA e controllo degli accessi | Di solito si aggiungono un gateway per gli strumenti e un livello di chat, poi se ne allineano i permessi ai percorsi dati che richiamano. | MCP nativo e un contratto di chat delimitato usano gli stessi servizi tipizzati, con l'autorizzazione nei percorsi di storage e di esecuzione. |
Come misurarlo: il vantaggio atteso è un lavoro ricco di relazioni più rapido, con meno overhead di mappatura, sincronizzazione e risorse. Misurate latenza delle query, picco di memoria, I/O su disco, acquisizione e sforzo di manutenzione sullo stesso carico di lavoro e sullo stesso hardware. Per grandi analisi tabellari o estensioni indispensabili, un data warehouse o uno stack SQL maturo può restare la scelta migliore.
Una risposta dell'IA diventa più utile quando sa collegare il documento giusto all'entità, al luogo e al momento giusti. Secondo i piani, Cygnus porterà nel modello di backend il recupero delle informazioni, la logica di business richiamabile e i registri delle conversazioni.
Il Model Context Protocol offre agli agenti autorizzati un modo individuabile e tipizzato per usare le funzioni di backend. L'individuazione e l'esecuzione degli strumenti seguono i permessi del chiamante, con gli stessi contratti dei servizi usati dalle applicazioni.
Il contratto di chat pianificato, neutrale rispetto al fornitore, copre messaggi, eventi di streaming, chiamate a strumenti, output strutturato e record persistenti di sessione e di esecuzione. I binding a modelli locali o remoti vengono scelti e qualificati esplicitamente per ciascun deployment.
Combinate il recupero full-text e vettoriale con il contesto di grafo, spaziale e storico. Mantenete i riferimenti alle versioni delle fonti e al contesto temporale scelto, così una persona può esaminare le evidenze e capire come si è formata una risposta.
Le regole di accesso ai dati si applicano prima della divulgazione e del ranking della ricerca. I contenuti recuperati e l'output del modello non conferiscono il permesso di agire; le azioni protette richiedono una propria autorizzazione e, dove previsto, una decisione umana.
«Quale carico si trovava ieri sulle navi all'interno dell'area di tempesta, e quali rapporti spiegano il rischio?»
Questo carico di lavoro marittimo proposto mette insieme l'intera architettura. Lo stesso approccio può collegare impianti, telemetria e manutenzione in applicazioni per l'energia, la manifattura o le infrastrutture.
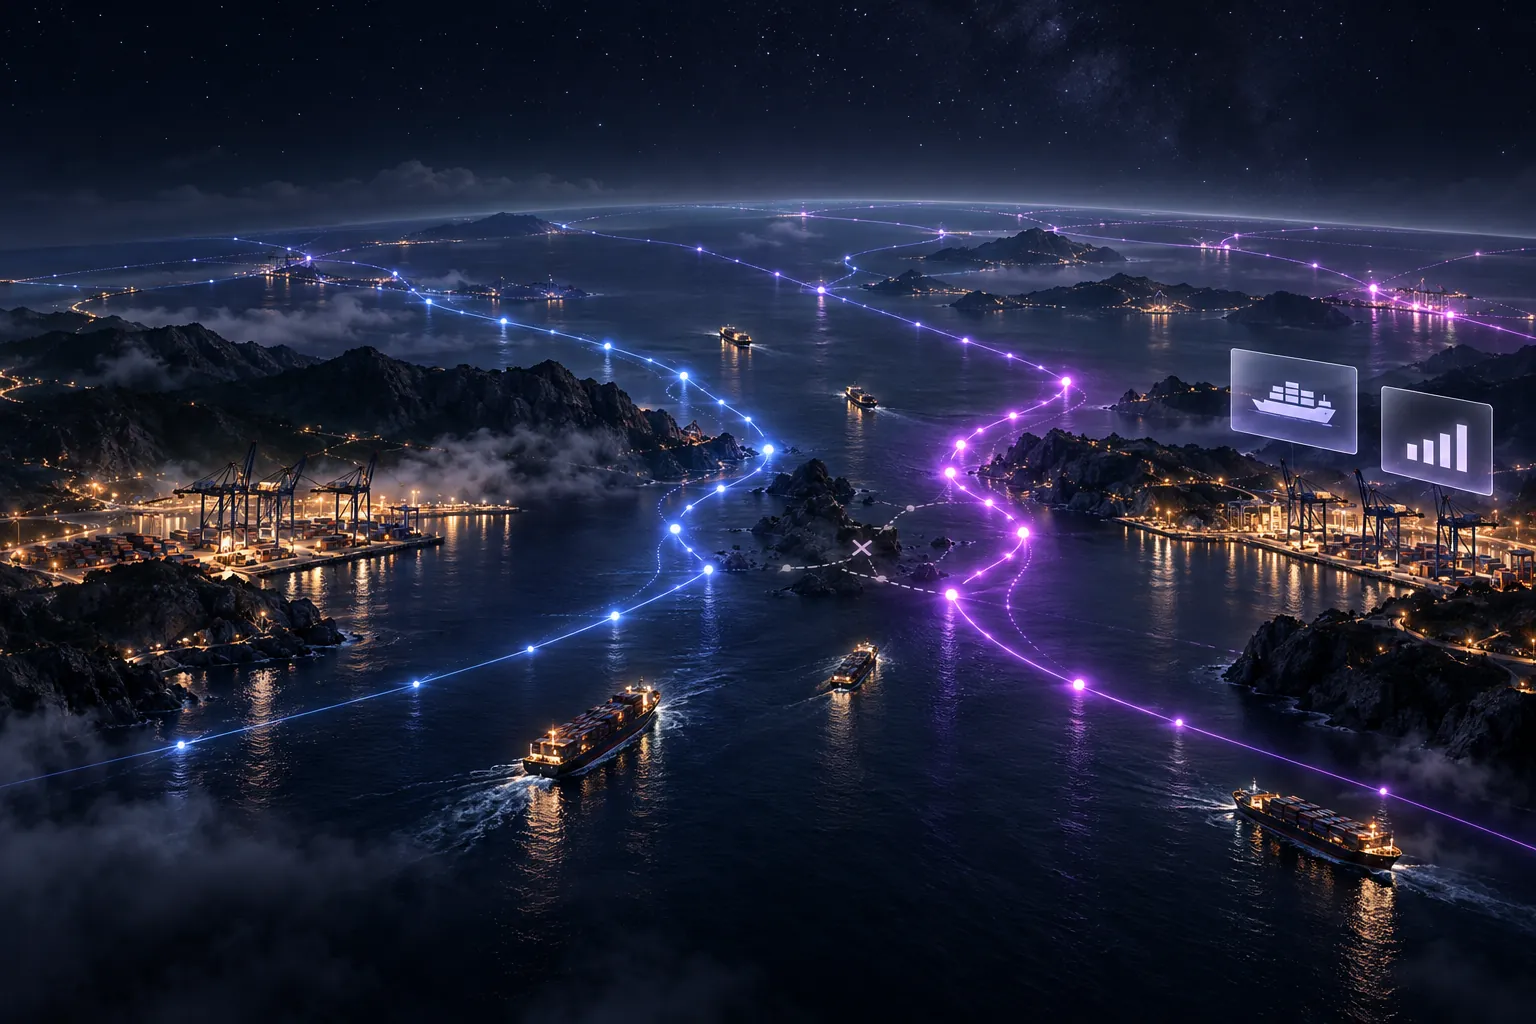
Come si costruisce la risposta
Selezionate l'intervallo di ieri e scegliete se la domanda usa ciò che si sapeva allora o le evidenze corrette in seguito.
Usate la selezione geospaziale e gli intervalli delle serie temporali per individuare le navi i cui tracciati hanno intersecato l'area di tempesta.
Attraversate le relazioni storiche della nave con carichi, operatori e porti, risolvendo solo le parti del grafo necessarie.
Combinate ricerca per parole chiave e ricerca semantica sulle versioni autorizzate dei documenti, collegate alle entità e al contesto temporale selezionati.
Un servizio tipizzato o uno strumento MCP restituisce le evidenze. La chat può spiegarle mantenendo le fonti e il contesto pertinente.
Separiamo ciò che è dimostrato da ciò che deve ancora arrivare, ed etichettiamo entrambi. Per NatusAI Cygnus è prevista la prima release (v1).
Cygnus custodisce i dati e la logica di business. NatusAI Lyra li mostra, NatusAI Auriga e Aquila permettono all'IA di lavorarci, NatusAI Orion ci costruisce applicazioni, NatusAI Draco lo esegue e NatusAI Gemini lo ripristina.
Che cos'è Cygnus. Un database a grafo temporale programmabile, in fase di pianificazione: un proprio linguaggio tipizzato, un modello di query ottimizzato e un runtime di backend. Grafo, dati geospaziali, vettori, semantica triple-store, serie temporali e ricerca full-text condividono un unico modello, con un'unica identità, un unico modello transazionale e un unico confine di autorizzazione.
| Profilo | Prima release | Confine |
|---|---|---|
| Embedded | Incluso | Un unico processo applicativo con storage locale. |
| Sviluppo | Incluso | Avvio da progetto vuoto e modalità di origine esplicite. |
| Produzione, singolo server | Incluso | Un nodo; backup, ripristino point-in-time e ripristino verificato inclusi nel perimetro. |
| Cluster | Escluso | Nessuna affermazione su sharding, replica, attraversamento distribuito o failover. |
| Carico di lavoro isolato | Escluso | Nessun profilo per carichi isolati qualificato separatamente. |
| Criterio | Soglia proposta | Stato |
|---|---|---|
| Design partner in produzione sul carico di riferimento | Almeno 3 | Non ancora superato |
| System of record in produzione con storico conservato | Almeno 1, con oltre 6 mesi di storico | Non ancora superato |
| Acquisizione continua di posizioni, classe di riferimento 32 vCPU | ≥ 100.000 rilevazioni/s | Non ancora superato |
| Navi all'interno di un poligono su 250.000 posizioni in tempo reale | p99 ≤ 150 ms | Non ancora superato |
| Recupero ibrido top-20 su 5 milioni di documenti | p99 ≤ 300 ms | Non ancora superato |
| Correttezza out-of-core | Dataset ≥ 24 × RAM | Non ancora superato |
| Overhead dell'autorizzazione a livello di elemento | ≤ 2 × policy a grana grossa | Non ancora superato |
| Commit confermati persi su un server | Zero | Non ancora superato |
| Test pianificati di ripristino verificato | 100% superati | Non ancora superato |
| Valutazioni guidate da agenti su progetti vuoti senza interventi umani | ≥ 70% riuscite | Non ancora superato |
Funziona sui vostri server come un unico sistema, senza servizi separati di ricerca, grafo e serie temporali per cui acquistare licenze e da proteggere.
Le risposte mantengono i riferimenti alla versione della fonte e al momento a cui si riferiscono.
Le regole di accesso ai dati si applicano prima che qualsiasi cosa venga mostrata o classificata. Il testo recuperato non conferisce mai all'IA il permesso di agire.
Ripristino verificato e ripristino point-in-time sono requisiti di release, non opzioni.
I problemi, gli approcci e i risultati utili delle nostre storie di settore e delle architetture di riferimento. Ogni esempio evidenzia le dimensioni che rendono il problema adatto al modello unificato pianificato di Cygnus.
01 · Banche e servizi finanziari
Conti → Transazioni → Indagine
Adatto a CygnusGrafoTripleStorico temporaleFull-text
02 · Energia e utility
Asset di rete → Letture dei contatori → Manutenzione
Adatto a CygnusGrafoGeospazialeSerie temporaliStorico temporale
03 · Manifattura
Impianto → Storico dei sensori → Intervento
Adatto a CygnusGrafoSerie temporaliStorico temporale
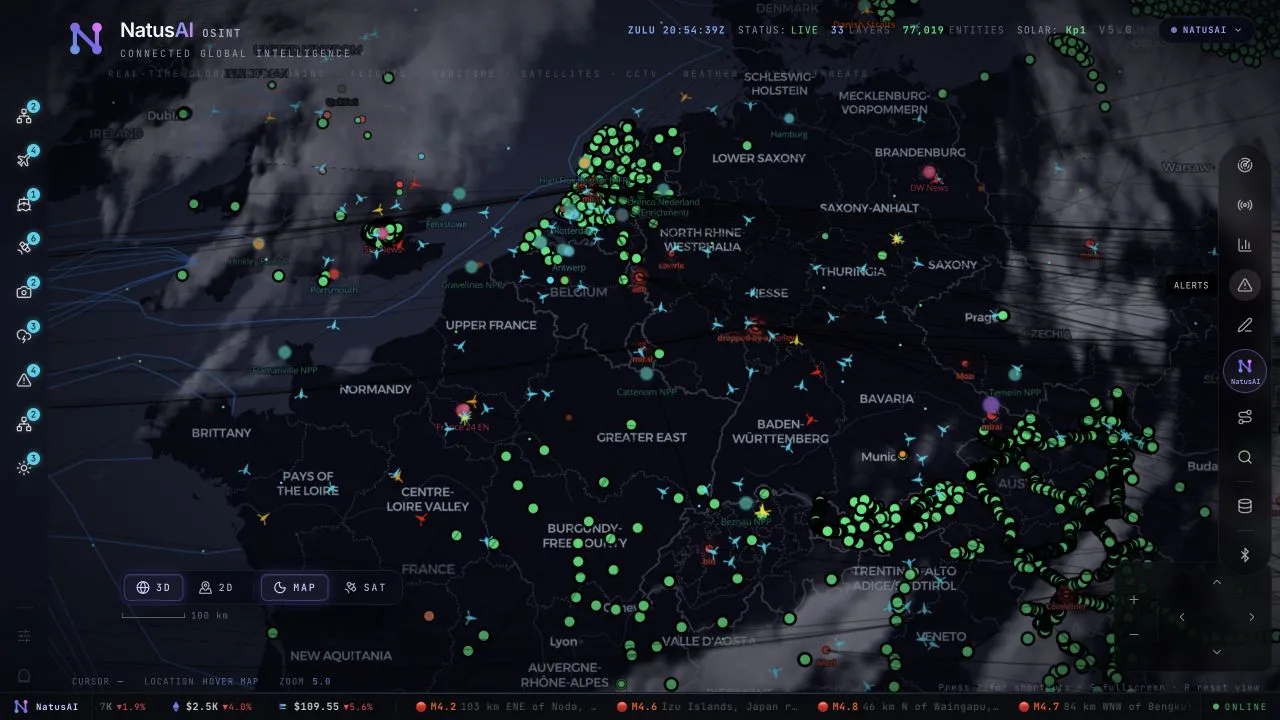
04 · OSINT
Luoghi ed eventi → Rapporti delle fonti → Valutazione
Adatto a CygnusGeospazialeGrafoFull-textStorico temporale
05 · Pianificazione solare e delle infrastrutture
Edifici → Condizioni solari → Scenari
Adatto a CygnusGeospazialeGrafoSerie temporali
06 · Telecomunicazioni
Cliente → Richiesta di assistenza → Passaggio a un operatore
Adatto a CygnusGrafoFull-textStorico temporaleChat
07 · Commercio e supply chain
Flussi commerciali → Dipendenze → Interruzione
Adatto a CygnusGrafoGeospazialeStorico temporaleChat
Queste storie descrivono progetti, flussi di lavoro esplorati e architetture di riferimento. Le etichette «Adatto a Cygnus» li collegano al prodotto pianificato; non attestano un deployment di Cygnus già rilasciato.

Una base complementare
NatusAI Lyra fornisce componenti web riutilizzabili per mappe, grafi, ricerca e flussi applicativi. L'integrazione più ampia con Orion e Cygnus fa parte della visione della piattaforma. Scoprite NatusAI Lyra
Componenti di interfaccia riutilizzabili per dashboard, mappe, documenti e conversazioni con l'IA.
Trasformate i documenti in conoscenza citabile, con la fonte a portata di clic.
Assistenti e strumenti di IA che operano entro i permessi e i budget fissati dalle vostre persone.
Risposte brevi per chi decide. Il vostro team tecnico trova i dettagli nella sezione espandibile qui sopra.
Non ancora. Per Cygnus è prevista una prima release, accettata solo dopo il superamento dei test di accettazione definiti. Lo stesso motore dei progetti per i nostri clienti è già collaudato sul campo, e il nostro team ci lavora già oggi.
No. La prima release punta a un unico server. Un modello di dati mondiale può girare su un solo nodo entro i limiti testati; una geografia globale non implica un cluster.
Non necessariamente. Cygnus è progettato per il lavoro connesso, ricco di relazioni. Per la reportistica tabellare di grandi dimensioni, un data warehouse o uno stack SQL maturo può restare la soluzione migliore, e Cygnus può affiancarlo.
Portatene una. Vi mostreremo come risponderebbe un modello connesso, e cosa servirebbe.
Oppure scriveteci a contact@natusai.com